Video Experimental Relacionado
Updated: Jan 24, 2026


WheelCon: A Wheel Control-Based Gaming Platform for Studying Human Sensorimotor Control
Published on: August 15, 2020
Rendimiento a nivel humano en juegos multijugador 3D con aprendizaje por refuerzo basado en la población
Max Jaderberg1, Wojciech M Czarnecki1, Iain Dunning2
1DeepMind, London, UK. lejlot@google.com jaderberg@google.com.

Los agentes de aprendizaje por refuerzo multiagente lograron un rendimiento a nivel humano en Quake III Arena. Estos agentes de IA aprendieron estrategias complejas utilizando solo píxeles y puntuaciones de juego, mostrando el potencial para aplicaciones del mundo real.
Área de la Ciencia:
- Inteligencia artificial
- Aprendizaje automático
- Sistemas de agentes múltiples
Sus antecedentes:
- El aprendizaje por refuerzo (RL) sobresale en juegos de un solo agente y dos jugadores.
- Los escenarios del mundo real involucran a múltiples agentes independientes que cooperan y compiten.
- Los enfoques de RL existentes a menudo luchan con dinámicas complejas de múltiples agentes.
Objetivo del estudio:
- Evaluar el potencial del aprendizaje por refuerzo multiagente (MARL) en entornos complejos y dinámicos.
- Para desarrollar un agente de IA capaz de rendimiento de nivel humano en un videojuego multijugador.
- Investigar las estrategias de aprendizaje utilizando únicamente la información sensorial y los objetivos del juego.
Principales métodos:
- Utilizó un marco de evaluación de estilo de torneo.
- Entrenó a una población de agentes de RL independientes al mismo tiempo utilizando un proceso de optimización de dos niveles.
- Los agentes aprendieron de miles de coincidencias paralelas en entornos generados al azar.
- La entrada consistió únicamente en píxeles y puntos de juego anotados.
Principales resultados:
- Logró un rendimiento de nivel humano en el modo Captura la bandera de Quake III Arena.
- Demostró que los agentes pueden aprender comportamientos complejos de cooperación y competencia.
- Los agentes desarrollaron señales de recompensa internas y representaciones del mundo rico de forma independiente.
- Mostró el aprendizaje efectivo de la entrada sensorial de alta dimensión.
Conclusiones:
- El aprendizaje por refuerzo multiagente tiene un potencial significativo para el avance de la inteligencia artificial.
- Este enfoque permite a los agentes de IA dominar tareas complejas en entornos dinámicos y multiagentes.
- Los hallazgos sugieren un camino viable hacia la IA que puede operar de manera efectiva en escenarios multiagente del mundo real.
Más Videos Relacionados
Videos de Conceptos Relacionados
 01:23
Reinforcement
Positive reinforcement occurs when a behavior is followed by the presentation of a rewarding stimulus, increasing the frequency of that behavior. For example:
 01:27
Corrosion of Reinforcement
However, over time and under certain conditions like carbonation, chloride ingress, and cracking this protective state can be compromised. Steel has areas with...
 01:24
Reinforcement Schedules
Once a behavior is learned,...
 01:25
Reinforcements in Concrete
 02:11
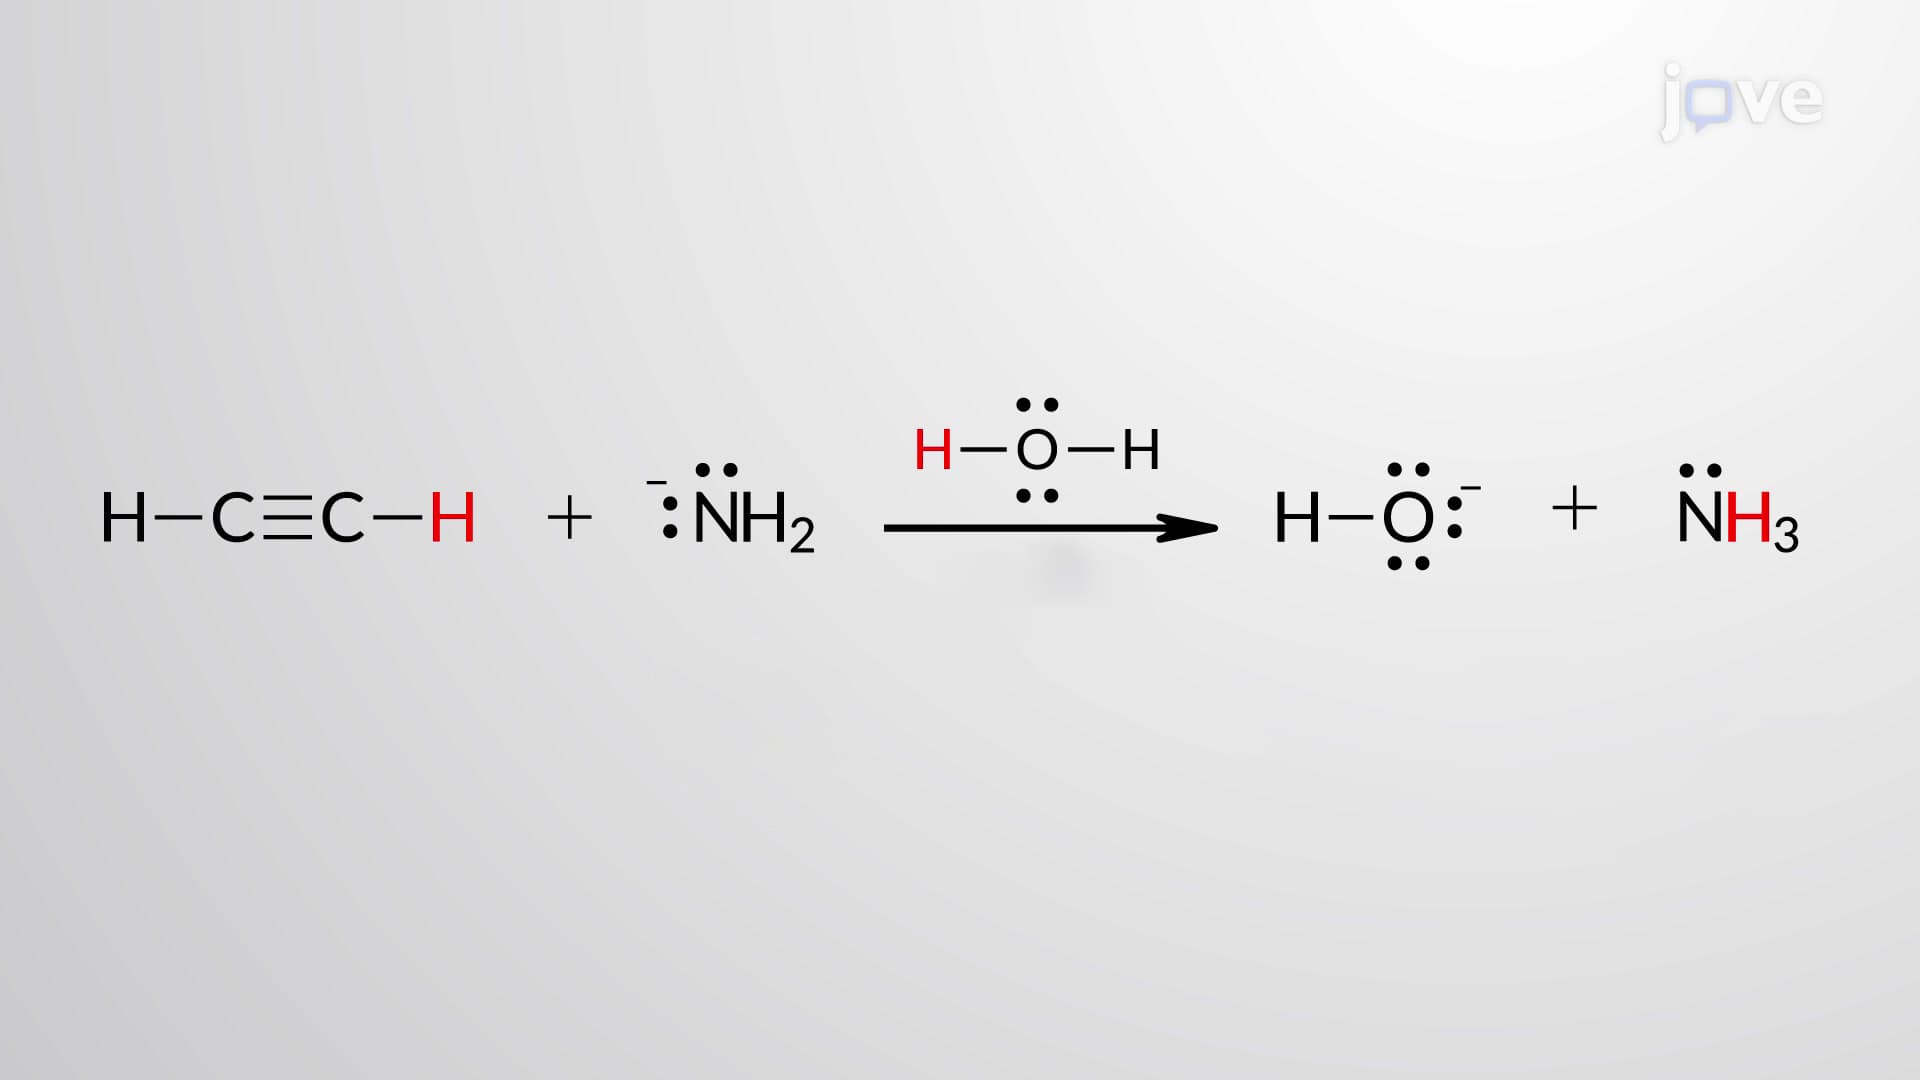
Leveling Effect and Non-Aqueous Acid-Base Solutions
The Leveling Effect of a Solvent
A generic acid (HA) reacts with the generic base (B-) to yield the corresponding conjugate base (A-) and conjugate acid (HB):
 02:04
Conservation of Small Populations