Video Experimental Relacionado
Updated: Sep 19, 2025
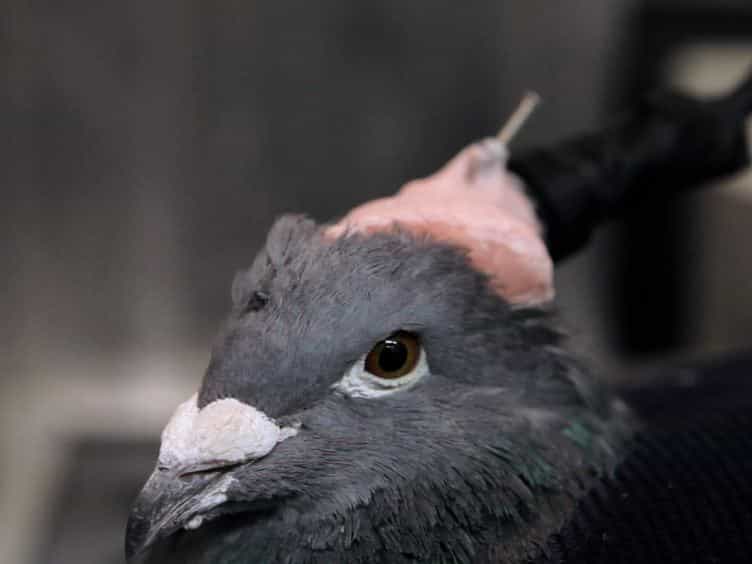

Recording Single Neurons' Action Potentials from Freely Moving Pigeons Across Three Stages of Learning
Published on: June 2, 2014
Aprendizaje de refuerzo a múltiples escalas de tiempo en el cerebro
Paul Masset1,2,3,4, Pablo Tano5, HyungGoo R Kim6,7,8,9
1Department of Molecular and Cellular Biology, Harvard University, Cambridge, MA, USA. paul.masset@mcgill.ca.

Los animales y los humanos usan múltiples escalas de tiempo para el aprendizaje por refuerzo, no solo una. Este estudio revela que las neuronas dopaminérgicas en ratones exhiben diversos descuentos temporales, mejorando el comportamiento adaptativo e informando nuevos algoritmos de aprendizaje.
Área de la Ciencia:
- La neurociencia
- Neurociencia computacional
- Aprendizaje automático
Sus antecedentes:
- El comportamiento adaptativo en entornos complejos requiere maximizar las recompensas.
- El aprendizaje por refuerzo (RL) modela este comportamiento adaptativo y caracteriza la actividad neuronal dopaminérgica.
- El RL clásico utiliza un factor de descuento único para las recompensas futuras.
Objetivo del estudio:
- Investigar el papel de múltiples escalas de tiempo en el aprendizaje de refuerzo biológico.
- Explorar los beneficios computacionales del aprendizaje de los agentes en varias escalas de tiempo.
- Para caracterizar las propiedades de descuento temporal de las neuronas dopaminérgicas.
Principales métodos:
- Agentes de aprendizaje de refuerzo desarrollados con múltiples escalas de tiempo de aprendizaje.
- Se registró la actividad de las neuronas dopaminérgicas en ratones durante dos tareas de comportamiento.
- Error de predicción de recompensa modelado y descuento temporal en respuestas neuronales.
Principales resultados:
- Los agentes de refuerzo con escalas de tiempo múltiples demostraron beneficios computacionales mejorados.
- Las neuronas dopaminérgicas en ratones mostraron una diversidad de constantes de tiempo de descuento.
- Un modelo explicó la heterogeneidad neuronal en el descuento temporal, incluidas las rampas de dopamina.
- Los factores de descuento de neuronas individuales fueron consistentes en todas las tareas, lo que indica propiedades específicas de la célula.
Conclusiones:
- Las escalas de tiempo múltiples son cruciales para el aprendizaje de refuerzo biológico eficiente.
- La heterogeneidad de las neuronas dopaminérgicas en el descuento temporal proporciona una base mecanicista para la valoración de la recompensa no exponencial.
- Los hallazgos ofrecen un nuevo marco para comprender la función dopaminérgica y diseñar algoritmos avanzados de RL.
Más Videos Relacionados
Videos de Conceptos Relacionados
 01:35
Long-term Potentiation
 01:24
Reinforcement Schedules
Once a behavior is learned,...
 01:01
Neuroplasticity