Regresión lineal semisupervisada: mejora de la eficiencia y la robustez en dimensiones altas
Video Experimental Relacionado
Updated: Sep 10, 2025
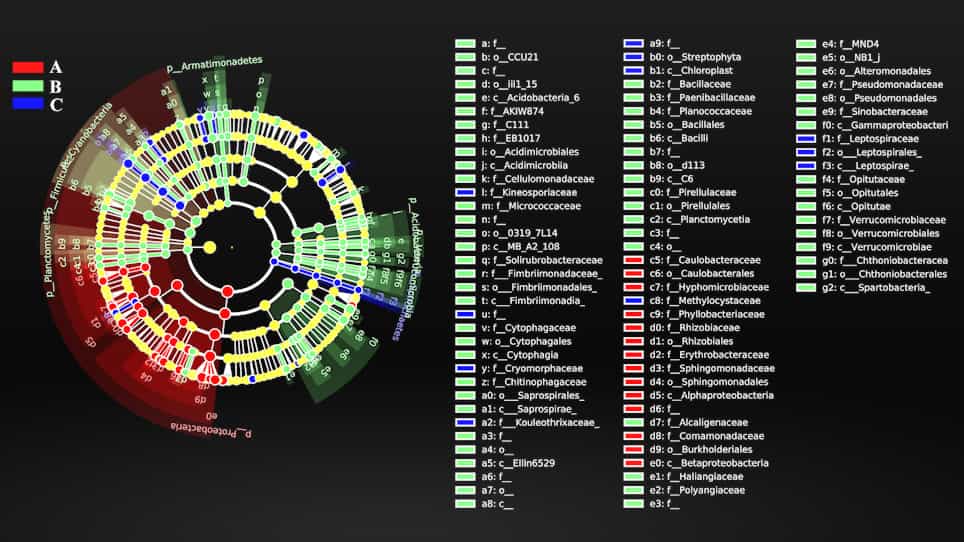
Assisted Selection of Biomarkers by Linear Discriminant Analysis Effect Size LEfSe in Microbiome Data
Published on: May 16, 2022
1Institute of Statistics and Big Data, Renmin University of China, Beijing 100872, China.

Este estudio demuestra que los datos sin etiqueta en el aprendizaje semisupervisado mejoran significativamente la precisión de la estimación de parámetros, incluso para modelos lineales correctamente especificados en entornos de alta dimensión. Estos hallazgos desafían los supuestos existentes y ofrecen métodos mejorados para el análisis de regresión.
Área de la Ciencia:
- Aprendizaje automático
- Las estadísticas
- Teoría del aprendizaje estadístico
Sus antecedentes:
- El entendimiento actual en el aprendizaje semisupervisado postula que los datos sin etiqueta benefician la estimación de parámetros lineales únicamente bajo la especificación errónea del modelo.
- Este paradigma es desafiado en entornos estadísticos de alta dimensión donde los datos sin etiqueta pueden ofrecer ventajas incluso para modelos correctamente especificados.
Objetivo del estudio:
- Desafiar la comprensión prevaleciente de la utilidad de los datos sin etiqueta en el aprendizaje semisupervisado.
- Demostrar las ventajas de incorporar muestras sin etiquetar en entornos de alta dimensión para la estimación de parámetros lineales.
- Desarrollar estimadores semi-supervisados robustos y eficientes para los coeficientes de regresión.
Principales métodos:
- Desarrollo de estimadores semi-supervisados robustos para los coeficientes de regresión, centrándose inicialmente en escenarios densos sin asumir pendientes de población escasas.
- Extensión de los métodos para mejorar la eficiencia en escenarios de pendiente lineal escasa.
- Estudios numéricos exhaustivos para validar el rendimiento de los métodos semi-supervisados propuestos.
Principales resultados:
- Demostró que las muestras adicionales sin etiqueta mejoran la precisión de la estimación de parámetros lineales en entornos de alta dimensión, contrariamente a las creencias anteriores.
- Demostró que aprovechar los datos sin etiquetar reduce el sesgo de estimación y mejora la robustez de la inferencia, incluso cuando el modelo verdadero es lineal.
- Se han propuesto nuevos métodos semisupervisados que ofrecen una mayor eficiencia, especialmente en escenarios de pendiente lineal escasa.
Conclusiones:
- Los datos sin etiqueta proporcionan beneficios significativos para la estimación de parámetros en el aprendizaje semisupervisado dentro de contextos de alta dimensión, independientemente de la especificación del modelo.
- Los estimadores semi-supervisados robustos desarrollados reducen efectivamente el sesgo y mejoran la precisión y la robustez en el análisis de regresión.
- Los métodos propuestos ofrecen avances prácticos para la utilización de datos sin etiqueta en el modelado estadístico.
Más Videos Relacionados

Videos de Conceptos Relacionados
 01:52
Regression Toward the Mean
 01:11
Residuals and Least-Squares Property
If the observed data point lies above the line, the residual is positive, and the line underestimates the actual data value for y. If the observed data point lies below the line, the residual is negative, and the line overestimates the actual data value for y.
The process of fitting the best-fit...
 01:25
Multiple Regression
Farmers can use multiple regression to determine the crop yield based on more than one factor, such as water availability, fertilizer, soil properties, etc. Here, the crop yield is the response or dependent variable as it depends on the other independent variables. The analysis requires the construction of a scatter plot...
 01:11
Regression Analysis
In regression analysis, a regression equation is determined based on the line of best fit– a line that best fits the data points plotted in a graph. This line is also called the regression line. The algebraic equation for the regression line is called the regression equation. It is represented as:
 02:07
Improving Translational Accuracy
 01:20
Calibration Curves: Linear Least Squares
For data that follow a straight line, the standard method for fitting is the linear...