Un conjunto de datos morfológicos anotados para las formas de palabras uzbekas: hacia enfoques basados en reglas y aprendizaje automático
Video Experimental Relacionado
Updated: Sep 10, 2025
Transcranial Direct Current Stimulation tDCS of Wernicke's and Broca's Areas in Studies of Language Learning and Word Acquisition
Published on: July 13, 2019
Nilufar Abdurakhmonova1, Raima Shirinova1, Rano Sayfullayeva1
1National University of Uzbekistan named after Mirzo Ulugbek, 4, University str., Tashkent city 100174, Uzbekistan.

Se creó un nuevo conjunto de datos con anotaciones morfológicas para la lengua uzbeka. Este recurso ayuda a la investigación del procesamiento del lenguaje natural (PNL), incluida la generación de textos y la corrección gramatical.
Área de la Ciencia:
- Lingüística computacional
- Procesamiento del lenguaje natural
- Lexicografía
Sus antecedentes:
- Disponibilidad limitada de recursos anotados para lenguas morfológicamente ricas como el uzbeko.
- Necesidad de conjuntos de datos estandarizados para evaluar algoritmos de análisis morfológico uzbekos.
- Importancia de la información morfológica para las tareas posteriores de PNL.
Objetivo del estudio:
- Introducir un nuevo conjunto de datos anotados manualmente para el análisis morfológico uzbeko.
- Proporcionar un punto de referencia para evaluar las diferentes técnicas de análisis morfológico uzbeko.
- Facilitar los avances en el PNL uzbeko.
Principales métodos:
- Creación de un conjunto de datos con 3022 formas de palabras uzbekas anotadas manualmente.
- La anotación incluye información sobre la raíz, el afijo y la parte del discurso.
- Implementación y comparación de un algoritmo de derivación basado en reglas y un modelo de campos aleatorios condicionales (CRF).
Principales resultados:
- Creación exitosa y publicación del conjunto de datos morfológicos de Uzbekistán.
- Análisis comparativo de enfoques basados en reglas y aprendizaje automático para el análisis morfológico uzbeko.
- Las pruebas de género en textos legales, político-económicos y educativos demostraron la generalización.
Conclusiones:
- El conjunto de datos anotados sirve como un recurso fundamental para la investigación de PNL de Uzbekistán.
- El estudio proporciona información sobre la efectividad de diferentes métodos de análisis morfológico para uzbekos.
- La investigación futura puede aprovechar este conjunto de datos para aplicaciones como la generación de texto y la corrección gramatical.
Videos de Conceptos Relacionados
 02:19
Morphogenesis
 03:36
Genome Annotation and Assembly
 01:11
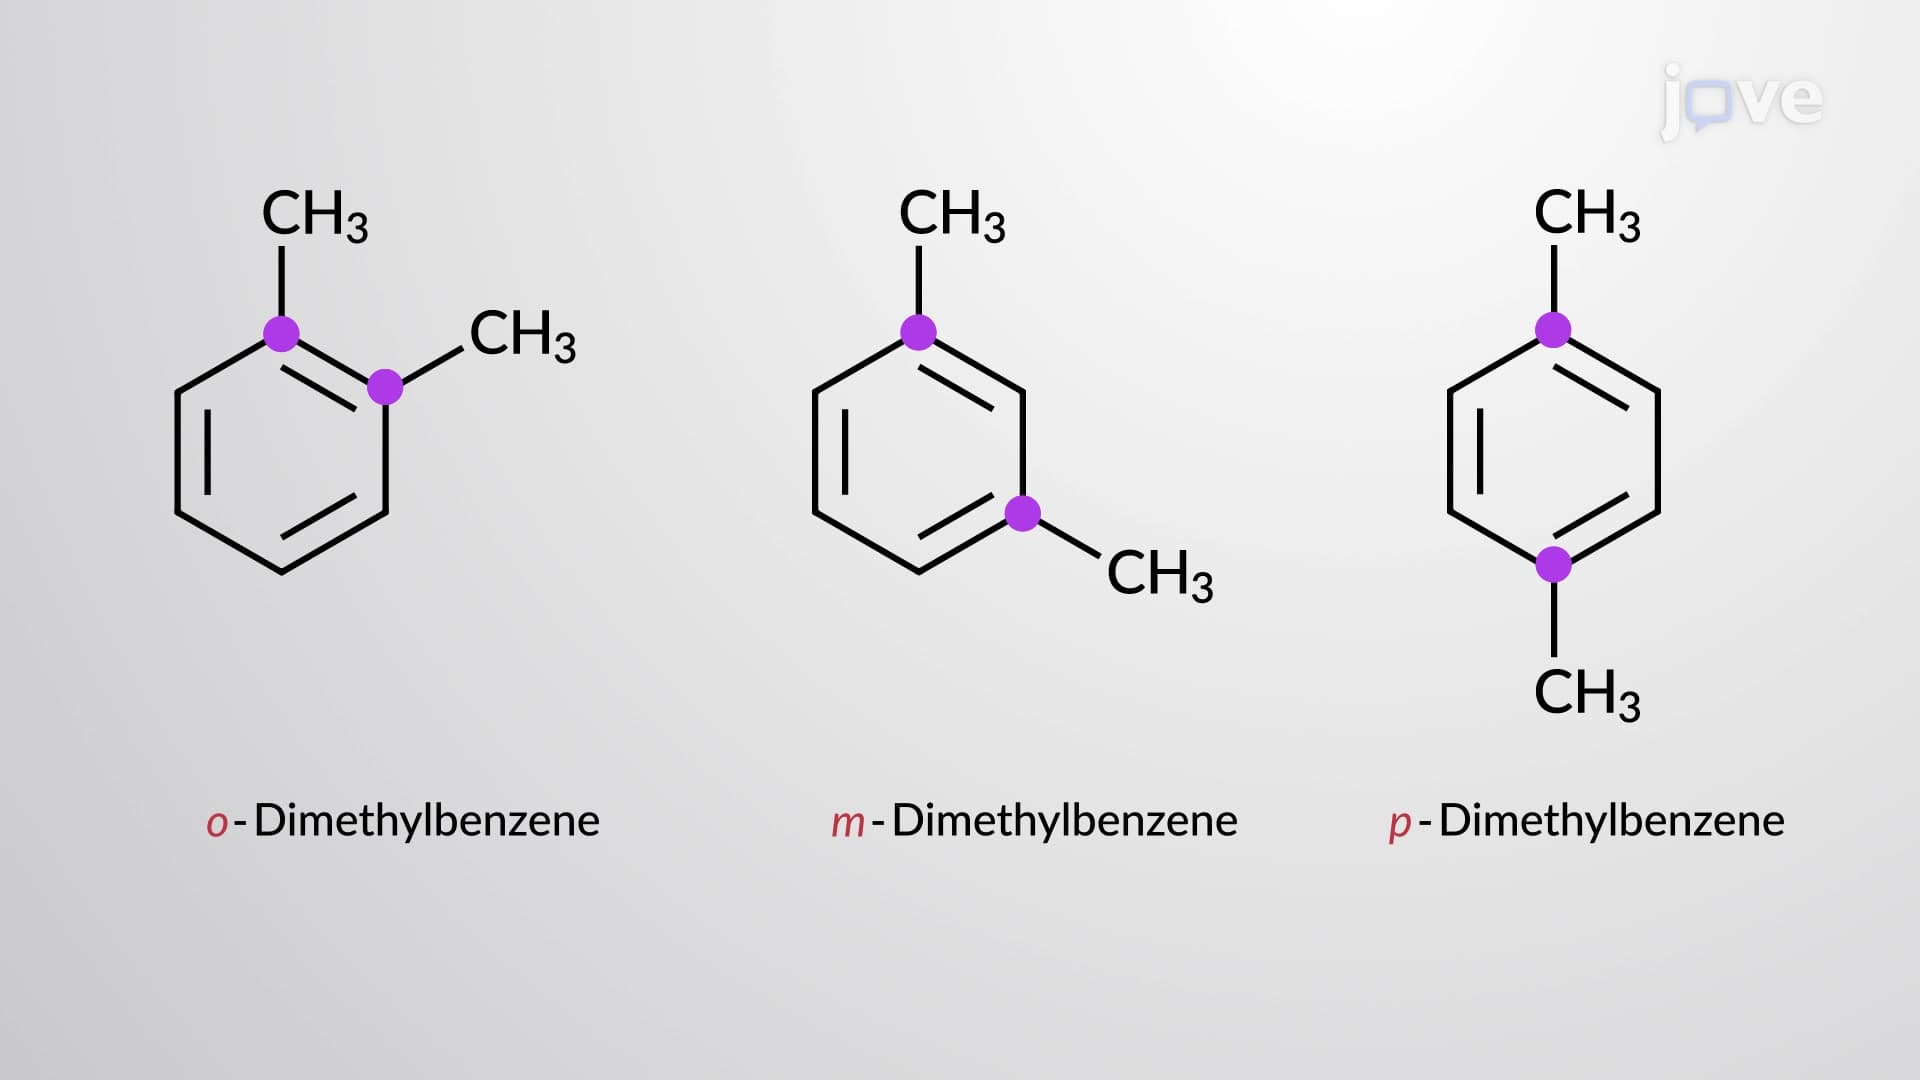
Nomenclature of Aromatic Compounds with Multiple Substituents
For disubstituted benzene derivatives, with two groups attached to the benzene ring, three constitutional isomers are possible. For example, consider dimethyl benzene, often called xylene, where the second methyl group can be substituted at the second, third, or fourth carbon. The relative position of the substituents is represented by prefixes ortho, meta, or...
 01:08
Data Collection by Observations
An astronomer viewing the motion and brightness of stars in the sky and recording the data is an example of observational data collection. A botanist recording...
 02:39
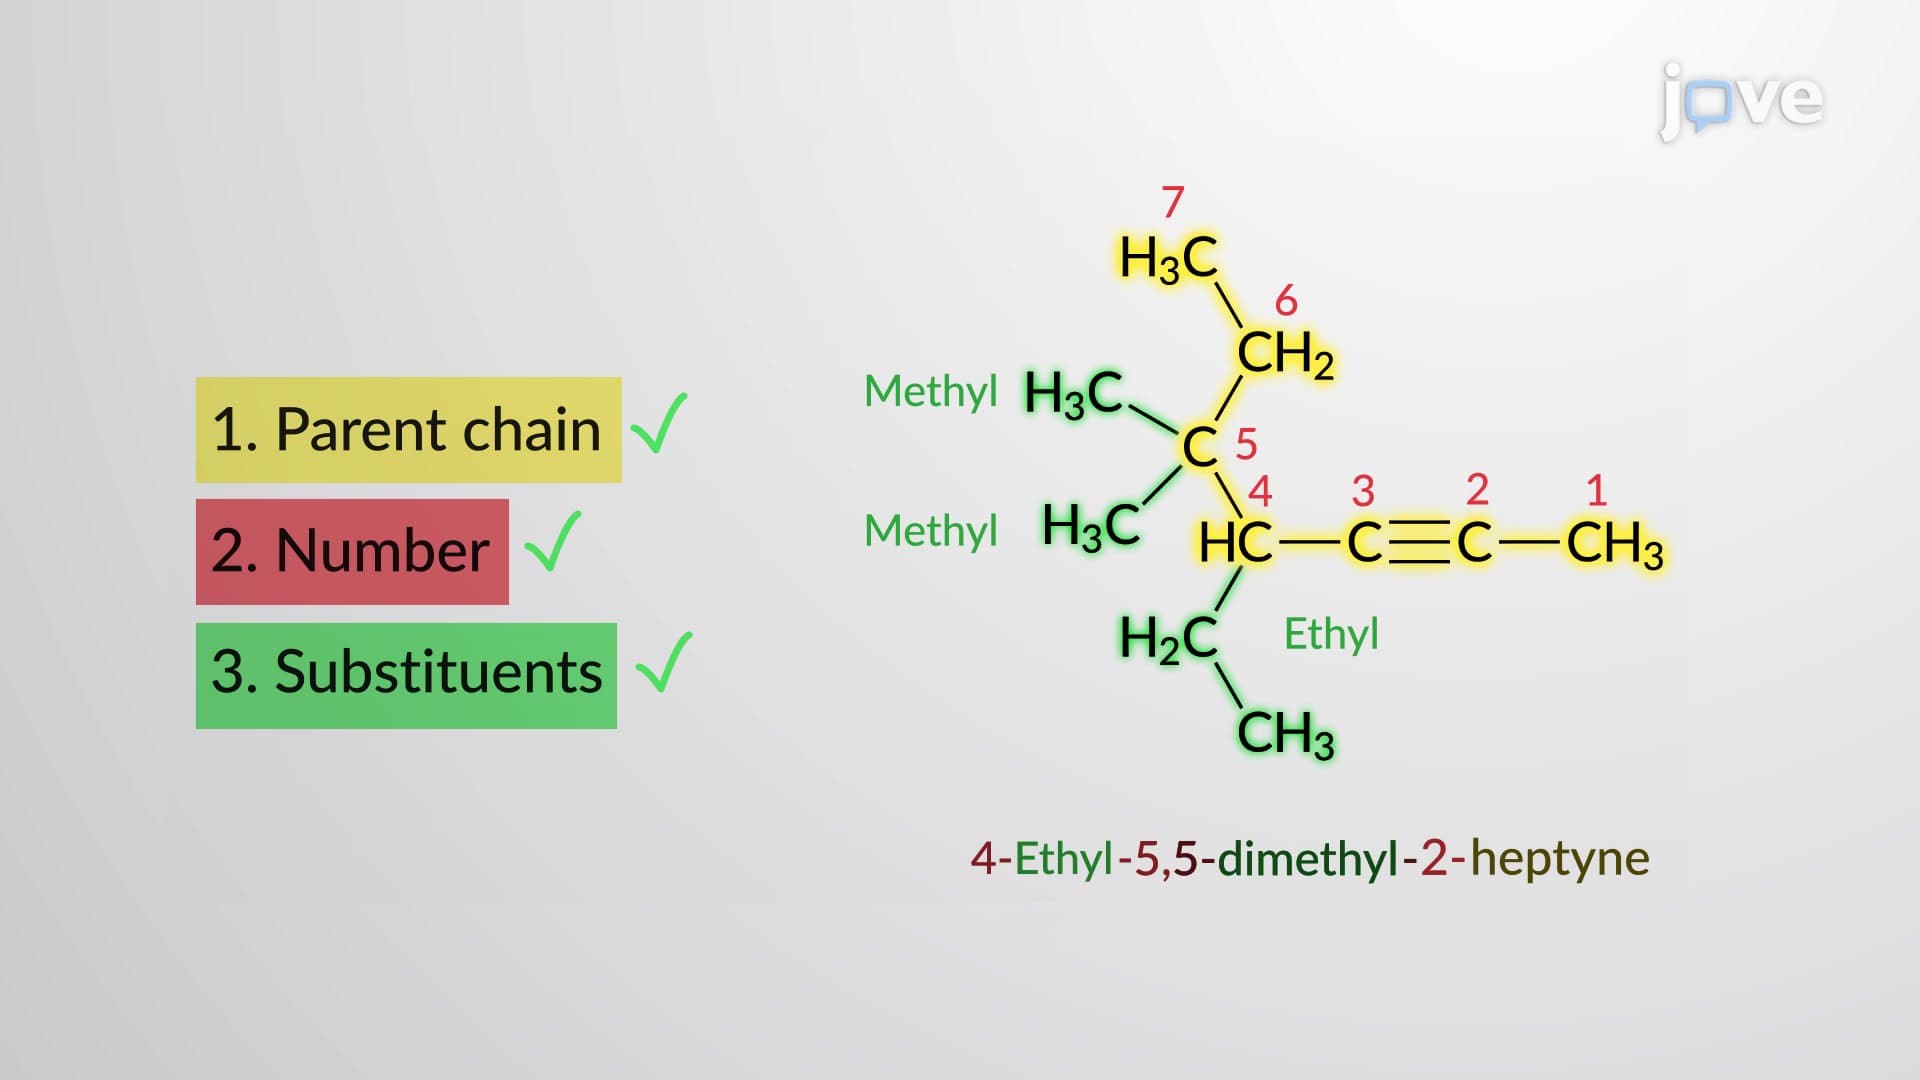
Nomenclature of Alkynes
 01:12
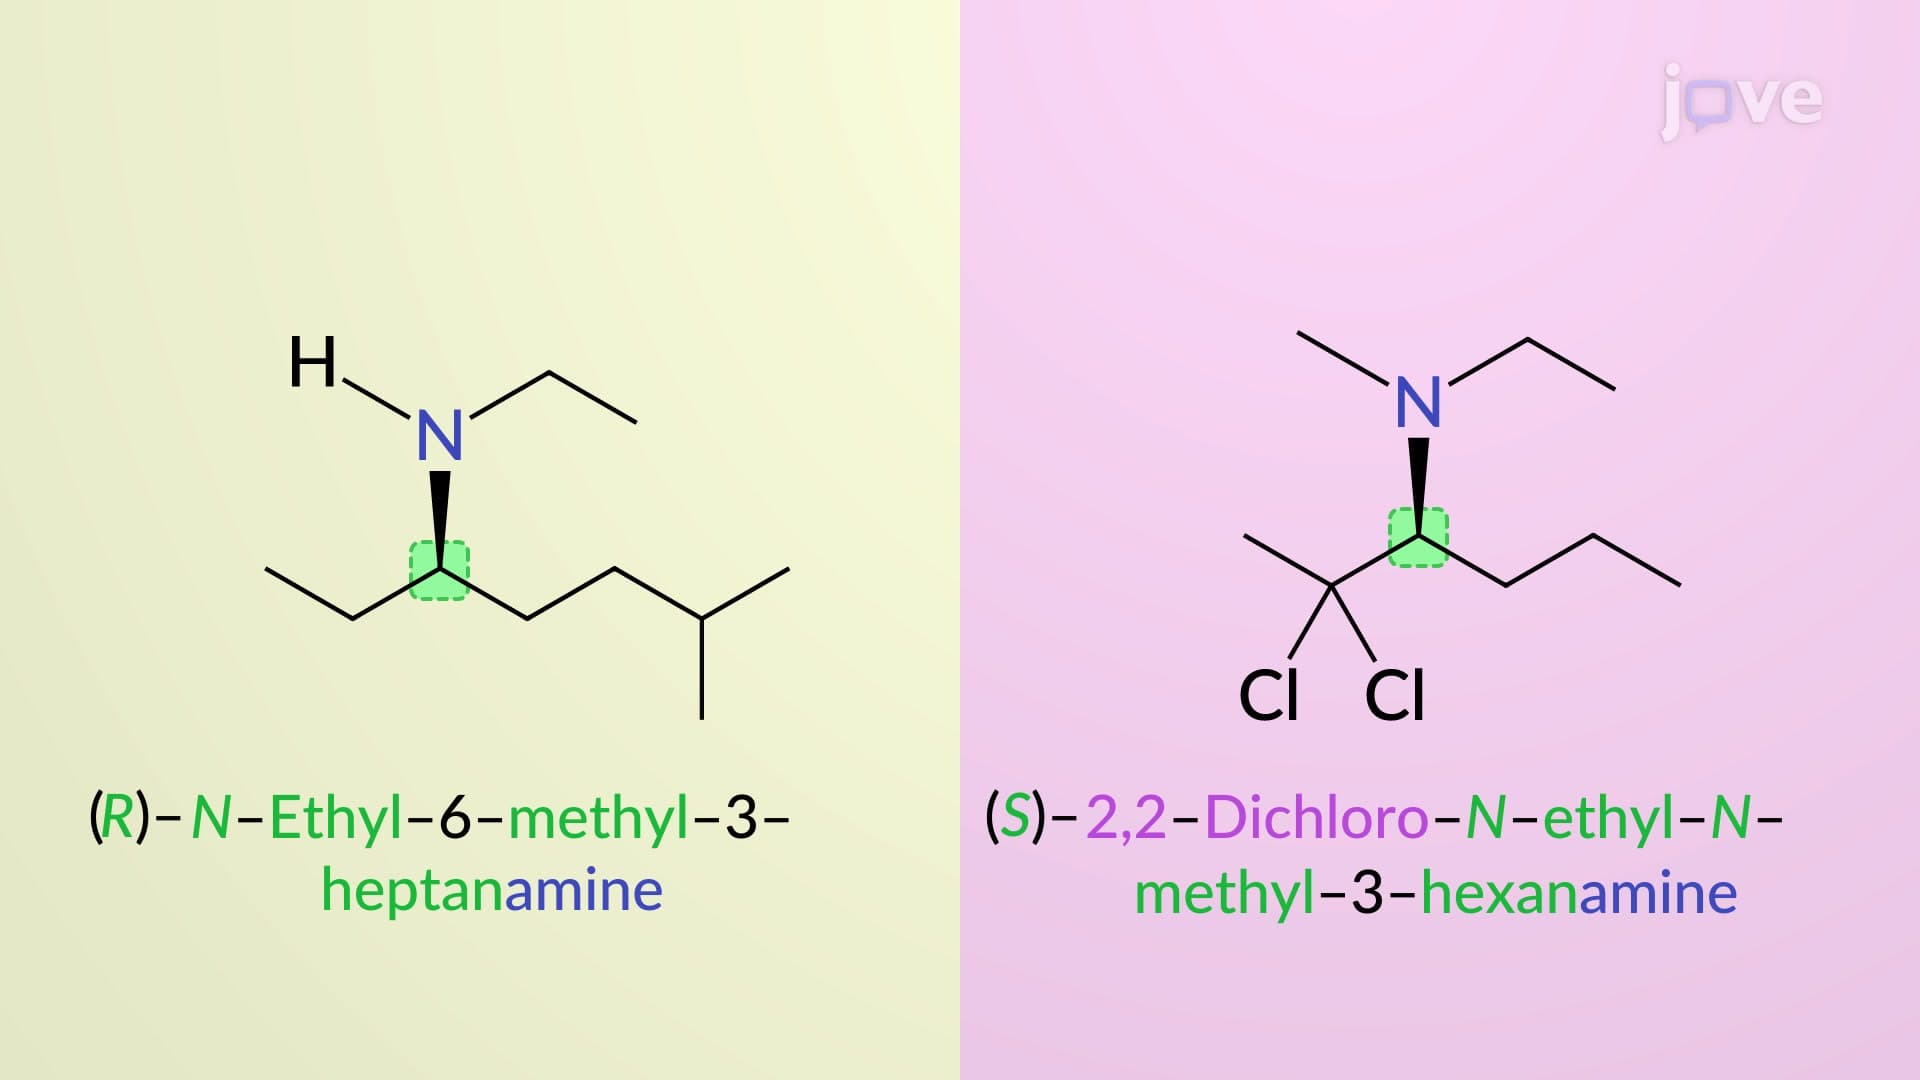
Nomenclature of Secondary and Tertiary Amines