Video Experimental Relacionado
Updated: Sep 9, 2025


Spatial Multiobjective Optimization of Agricultural Conservation Practices using a SWAT Model and an Evolutionary Algorithm
Published on: December 9, 2012
Un algoritmo de aprendizaje de refuerzo multiobjetivo basado en optimización de descomposición para obtener frentes

Este estudio presenta MORL/D-VR, un nuevo algoritmo no lineal para el aprendizaje por refuerzo multiobjetivo (MORL). Aborda efectivamente los frentes de Pareto no convexos en problemas complejos de toma de decisiones.
Área de la Ciencia:
- Inteligencia artificial
- Aprendizaje automático
- Optimización
Sus antecedentes:
- El aprendizaje por refuerzo multiobjetivo (MORL) busca frentes de Pareto (PF) en los procesos de decisión de Markov multiobjetivo (MOMDP).
- Los algoritmos MORL existentes luchan con PF no convexos, lo que limita su aplicabilidad.
- Esta limitación dificulta el descubrimiento de políticas diversas y óptimas en escenarios complejos.
Objetivo del estudio:
- Proponer un nuevo algoritmo MORL no lineal, MORL/D-VR, capaz de manejar PF no convexos.
- Proporcionar una garantía teórica para encontrar las políticas óptimas de Pareto independientemente de la forma de PF.
- Mejorar los métodos de gradiente de políticas para mejorar el rendimiento y la diversidad.
Principales métodos:
- Descomposición de los PDM en PDM de objetivo único utilizando el enfoque de Tchebycheff.
- Aplicación de un algoritmo mejorado de gradiente de política, gradiente de política de utilidad esperada (EUPG).
- Implementación de técnicas de reducción de la varianza y adaptación del vector de peso para mejorar el rendimiento.
Principales resultados:
- MORL/D-VR demuestra la óptimalidad teórica de Pareto para PF no convexos.
- El algoritmo logra el rendimiento deseable tanto en problemas de PF convexos como no convexos.
- Los resultados experimentales muestran que MORL / D-VR supera a los algoritmos MORL actuales.
Conclusiones:
- MORL/D-VR supera efectivamente las limitaciones de los algoritmos MORL existentes en el manejo de PF no convexos.
- El método propuesto ofrece una base teórica para lograr la óptimalidad de Pareto en MOMDP complejos.
- MORL/D-VR representa un avance significativo en MORL, mejorando el descubrimiento y el rendimiento de las políticas.
Más Videos Relacionados
 10:36
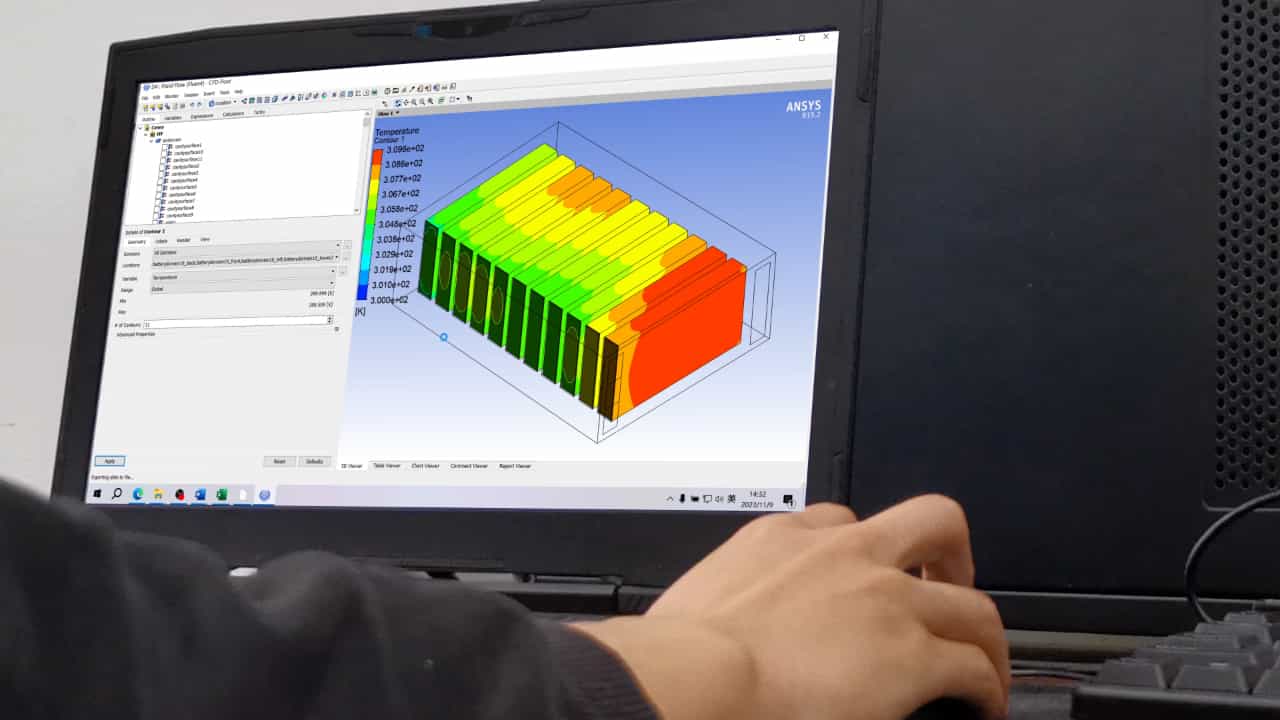
Author Spotlight: Optimization of Airflow Velocities in Battery Cooling Systems for Enhanced Thermal Performance and Reduced Energy Consumption
Published on: November 3, 2023
 13:54
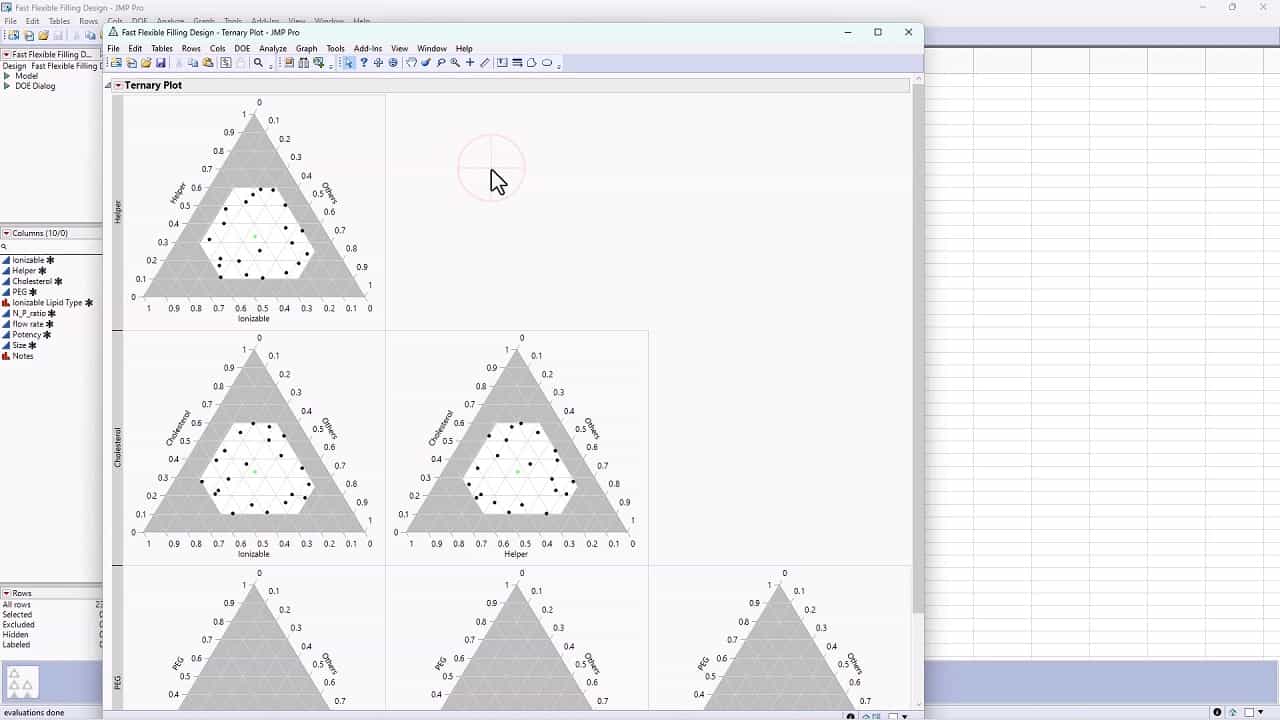
A Workflow for Lipid Nanoparticle LNP Formulation Optimization using Designed Mixture-Process Experiments and Self-Validated Ensemble Models SVEM
Published on: August 18, 2023
Videos de Conceptos Relacionados
 01:29
Mechanistic Models: Compartment Models in Algorithms for Numerical Problem Solving
In individual population analyses, different algorithms are employed, such as Cauchy's method, which uses a...
 01:09
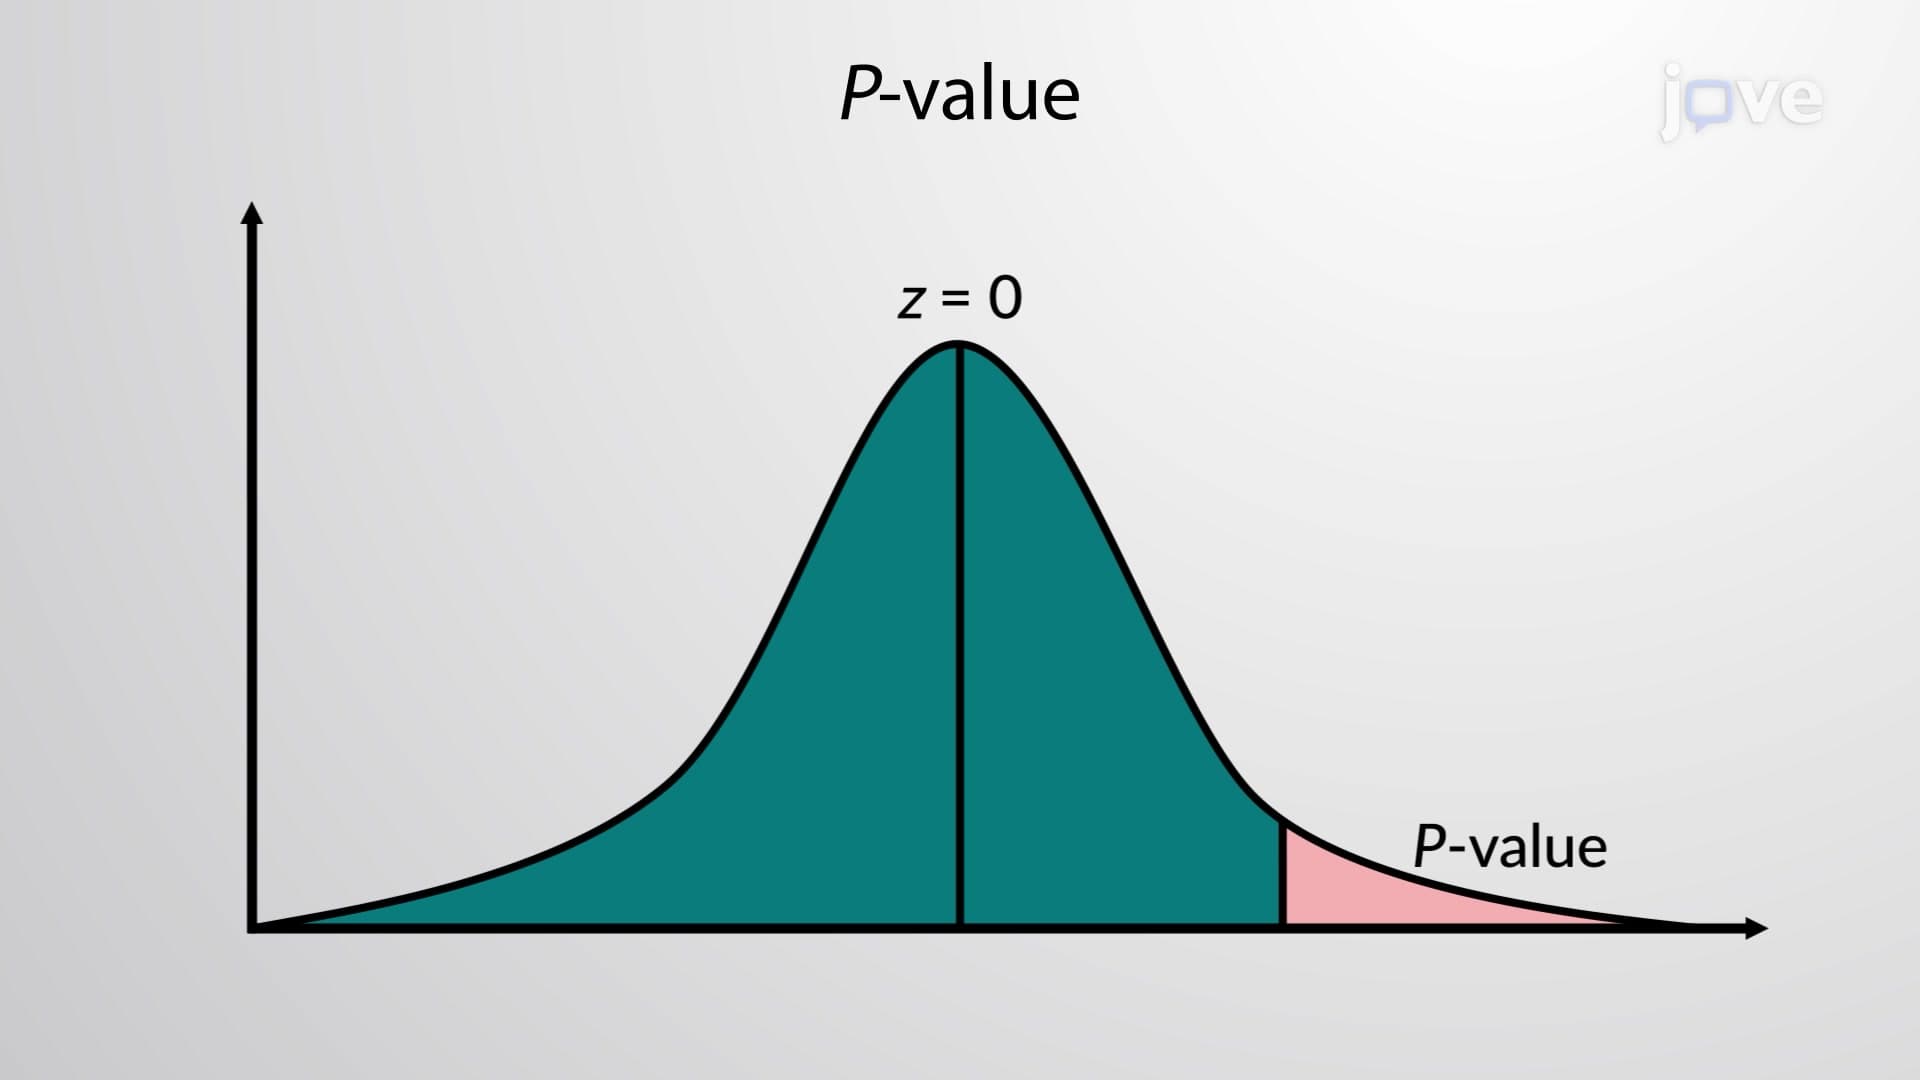
Decision Making: P-value Method
First, a specific claim about the population parameter is proposed. The claim is based on the research question and is stated in a simple form. Further, an opposing statement to the claim is also stated. These statements can act as null and alternative hypotheses: a null hypothesis would be a neutral statement while the alternative hypothesis can...
 00:48
Optimal Foraging
 01:16
Statically Indeterminate Problem Solving
 01:13
Stability of Equilibrium Configuration: Problem Solving
Problem-solving in the context of the stability of equilibrium configuration...
 01:13
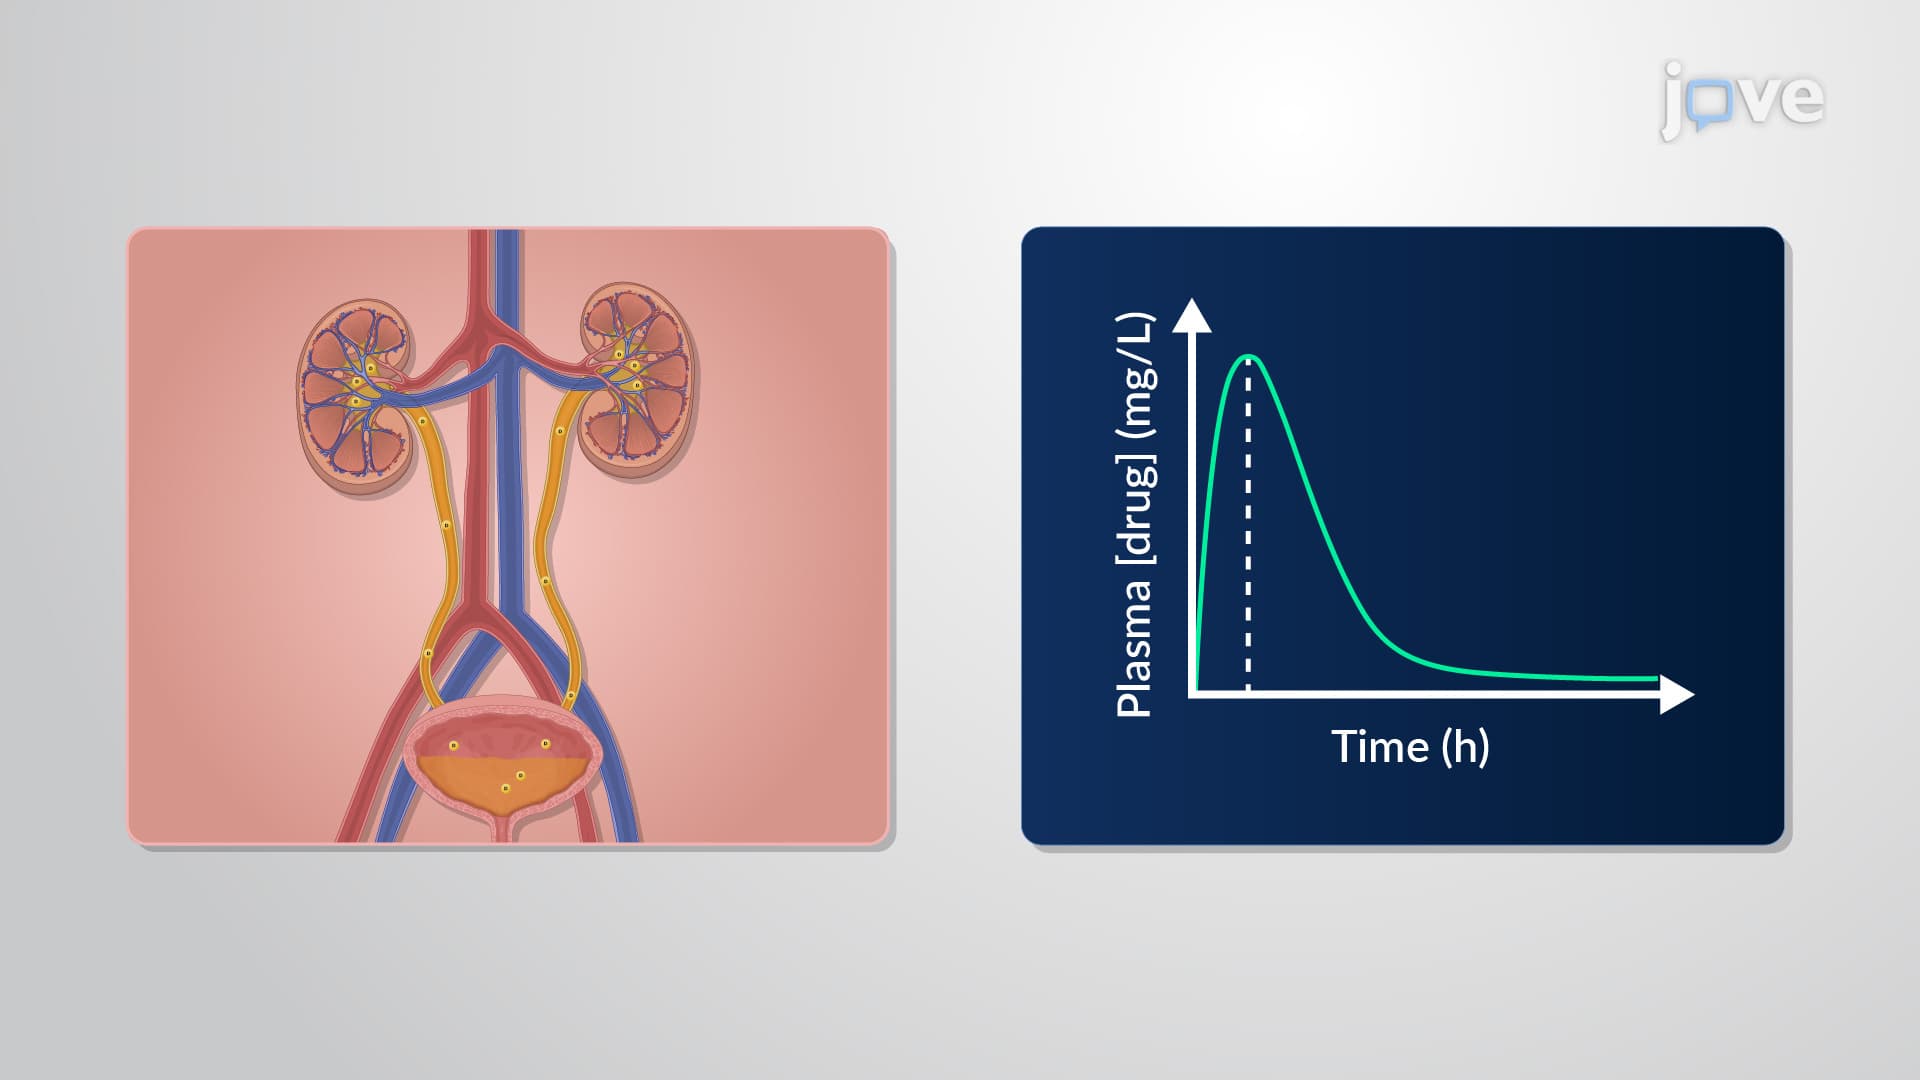
Parameters Affecting Nonlinear Elimination: Zero-Order Input, First-Order Absorption and Two-Compartment Model
When a drug is administered through a constant intravenous infusion and eliminated via nonlinear pharmacokinetics, it follows zero-order input. For example, oral drugs undergo first-order absorption upon administration and are eliminated through nonlinear pharmacokinetics.
In the case of subcutaneously administered drugs,...