Video Experimental Relacionado
Updated: Feb 12, 2026
Constructing and Visualizing Models using Mime-based Machine-learning Framework
Published on: July 22, 2025
Un modelo QSAR basado en el aprendizaje automático para predecir la toxicidad de los pesticidas comerciales para
Simin Li1, Peiwen Zhang1, Rong Zhou1
1Research Center of Solid Waste Pollution and Prevention, Nanjing Institute of Environmental Science, Ministry of Ecology and Environment, Nanjing 210042, PR China.

Un nuevo marco de aprendizaje automático predice la toxicidad de los plaguicidas para las lombrices de tierra utilizando la estructura molecular, las condiciones del suelo y el tipo de formulación. Este enfoque ofrece un método rápido y rentable para evaluar los riesgos ambientales de los plaguicidas.
Área de la Ciencia:
- Química del medio ambiente Química del medio ambiente
- Toxicología Toxicología.
- Química computacional es la química computacional.
Sus antecedentes:
- Los pesticidas comerciales son vitales para la agricultura, pero representan un riesgo para los organismos del suelo no objetivo, como las lombrices de tierra.
- La evaluación de la toxicidad de los plaguicidas en condiciones realistas del suelo es crucial para la protección del medio ambiente.
Objetivo del estudio:
- Desarrollar un marco de aprendizaje automático basado en la relación cuantitativa estructura-actividad (ML-QSAR) para predecir la toxicidad de los pesticidas comerciales para las lombrices de tierra.
- Para integrar la estructura molecular, los parámetros físicoquímicos del suelo y los tipos de formulación para una predicción precisa de la toxicidad.
Principales métodos:
- Utilizó un conjunto de datos combinado de 947 datos de toxicidad de plaguicidas privados y públicos.
- Desarrolló 30 modelos de clasificación binaria utilizando diez algoritmos de aprendizaje automático, dos conjuntos de descriptores y una huella molecular.
- Empleado árbol de decisión de aumento de gradiente con descriptores RDKit (GBDT-RDKit) como el modelo óptimo, validado utilizando métricas como precisión, precisión, recuerdo y AUROC.
- Definido el dominio de aplicabilidad del modelo utilizando la similitud de Tanimoto.
Principales resultados:
- El modelo óptimo GBDT-RDKit logró un alto rendimiento de predicción (precisión = 0.83, AUROC = 0.88).
- El análisis de SHapley Additive Explanations (SHAP) reveló la influencia significativa de la estructura química, los parámetros del suelo y los tipos de formulación en la toxicidad.
- Desarrolló clasificadores de tres clases para priorizar los pesticidas altamente tóxicos.
Conclusiones:
- El marco ML-QSAR desarrollado proporciona un método rápido y rentable para evaluar la toxicidad de los plaguicidas para las lombrices de tierra en el suelo.
- Este enfoque puede ayudar en la evaluación del riesgo ambiental de los plaguicidas comerciales, apoyando prácticas agrícolas sostenibles.
Más Videos Relacionados
 07:13
Comparison of Predictive Performance of Three Lymph Node Staging Systems in Colorectal Signet Ring Cell Carcinoma Based on Machine Learning Model
Published on: April 18, 2025
 05:47
In Silico Modeling Method for Computational Aquatic Toxicology of Endocrine Disruptors: A Software-Based Approach Using QSAR Toolbox
Published on: August 28, 2019
Videos de Conceptos Relacionados
 01:30
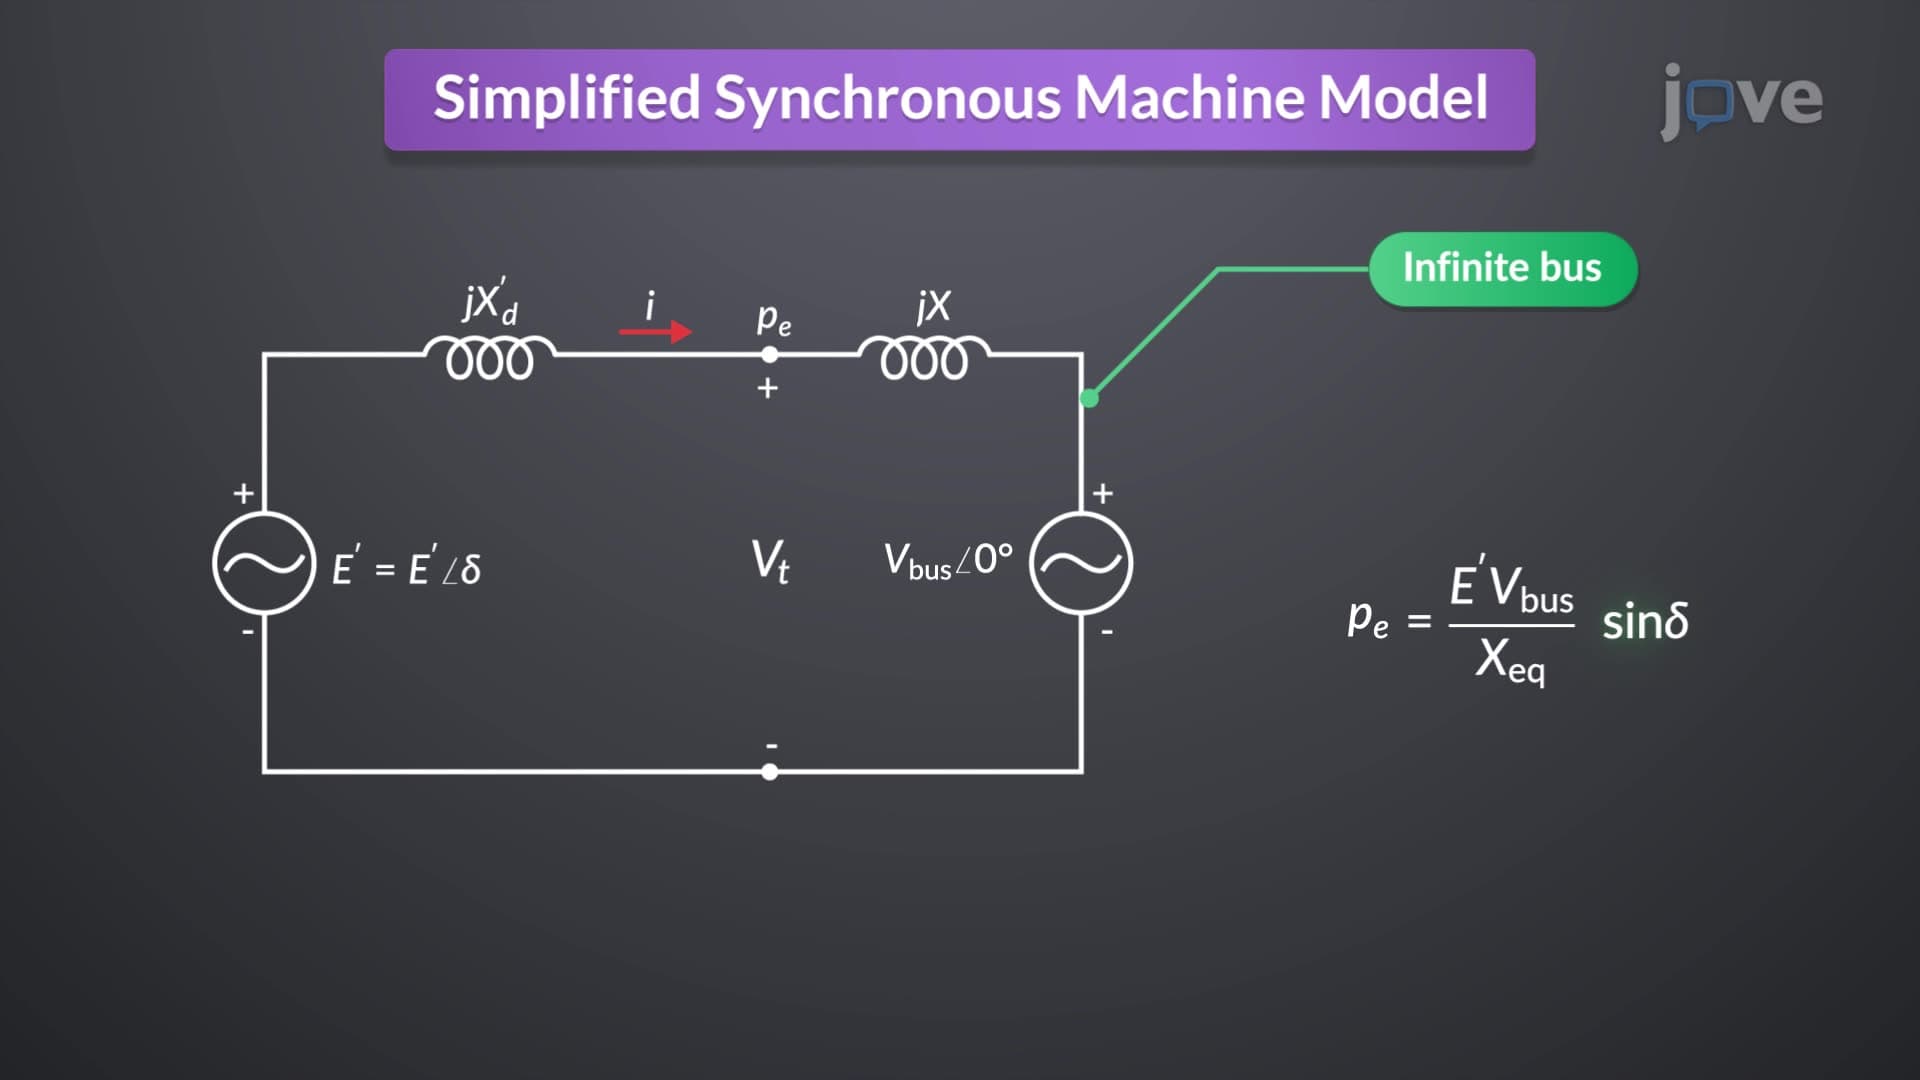
Simplified Synchronous Machine Model
In this model, each generator is connected to a...
 01:24
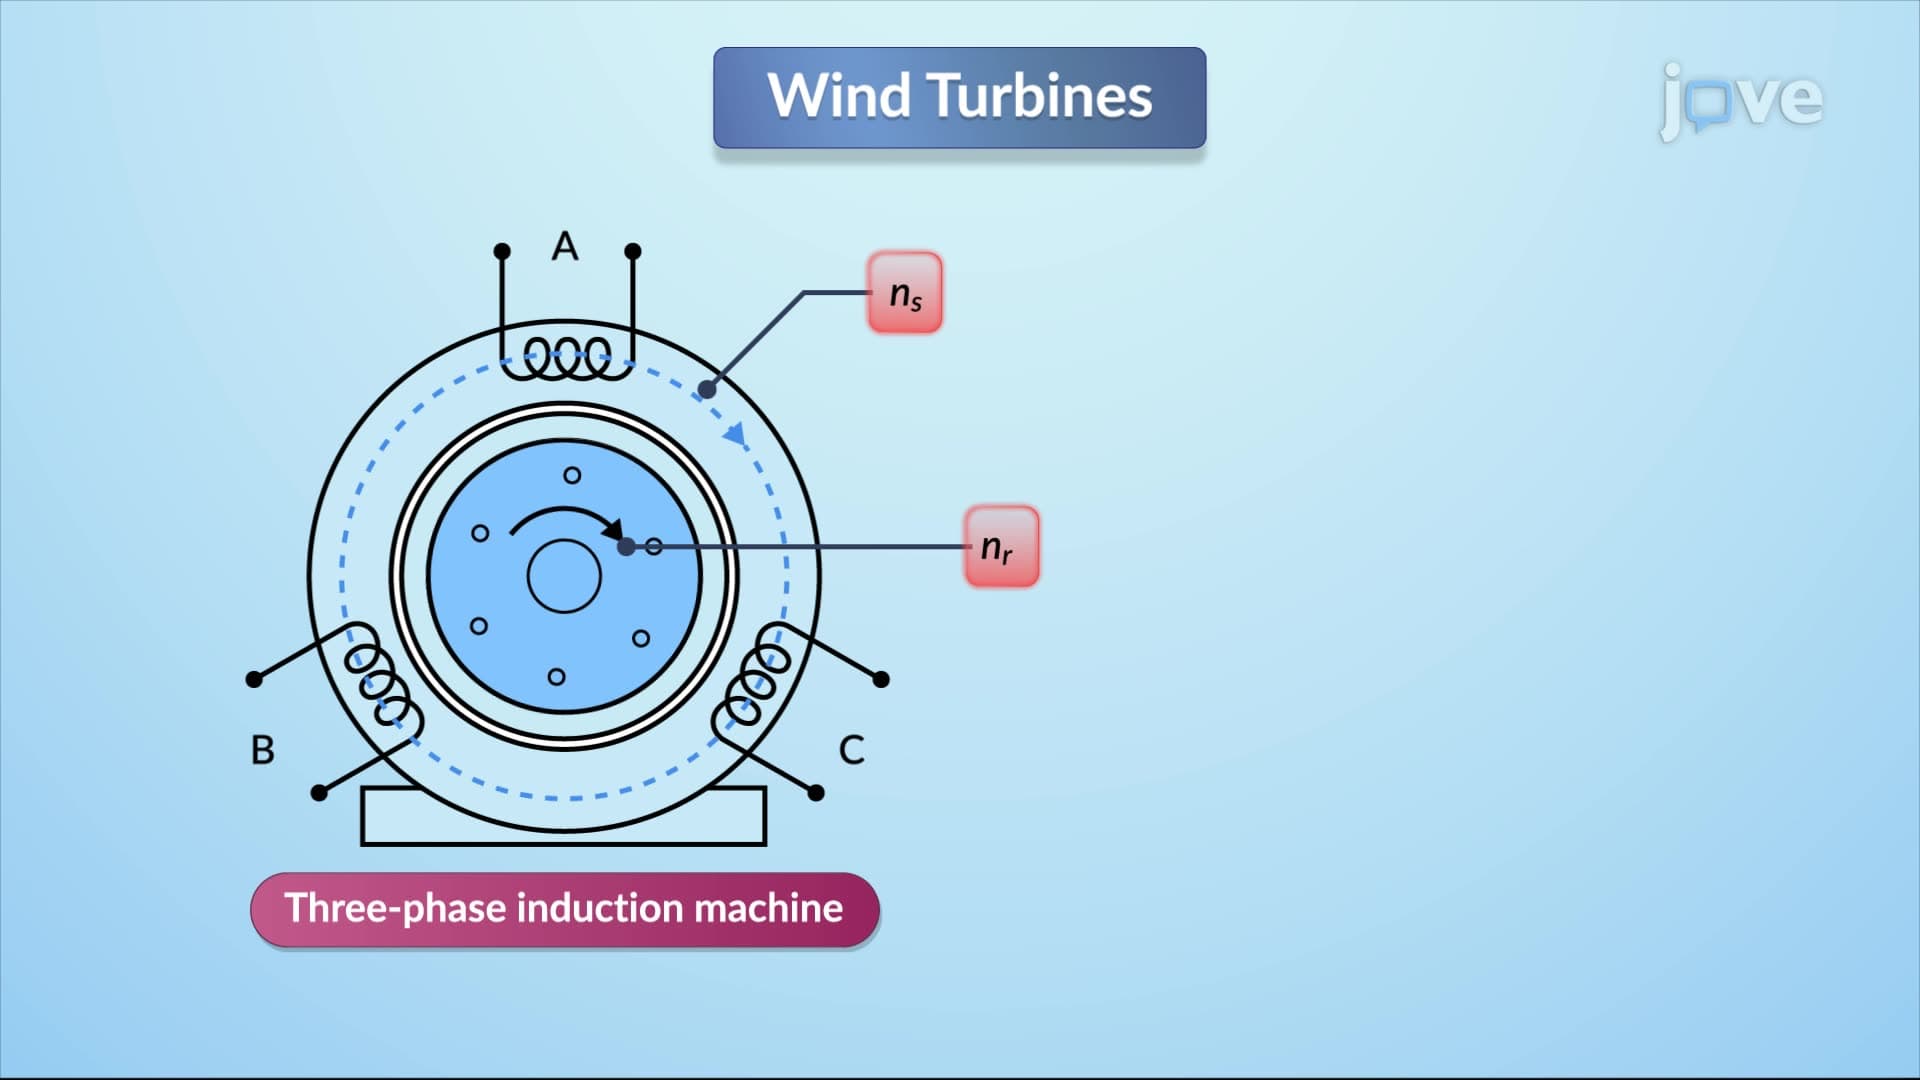
Wind Turbine Machine Models
Induction machines interact through the rotating magnetic field generated by the stator and the rotor. The key parameter is slip, which is the difference between synchronous speed and rotor speed relative to synchronous speed. Slip is...
 02:27
Predicting Molecular Geometry
 01:19
Machines
A free-body diagram of the...
 01:30
Machines: Problem Solving II
 01:03
Prediction Intervals
However, the point estimate is most likely not the exact value of the population parameter, but close to it. After calculating point estimates, we construct interval estimates, called confidence intervals or prediction intervals. This prediction interval comprises a range of values unlike the point estimate and is a better predictor of the observed sample value, y.