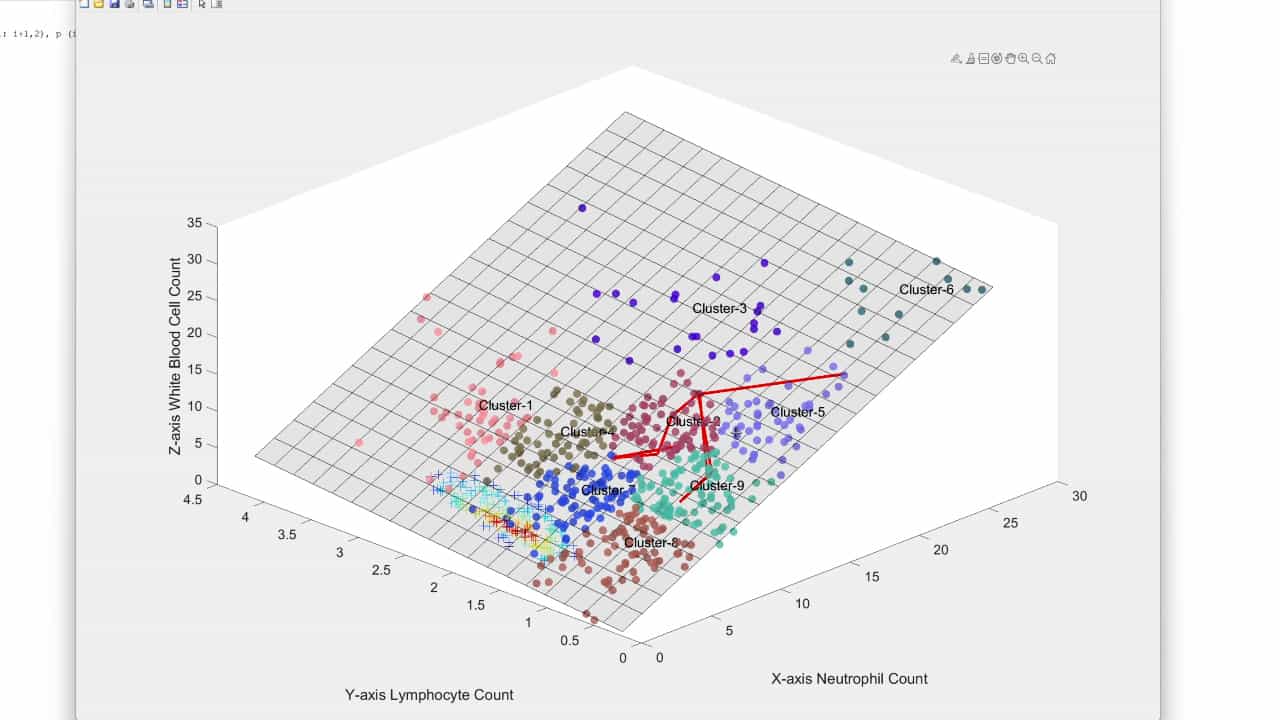
一个机器学习模型来源于时间过程基因表达数据集的分析,揭示了暂时稳定的基因标记,预测了败血症的死亡率
Min Huang1, Mihir R Atreya, Andre Holder2
1Department of Biomedical Informatics, Emory University School of Medicine, Atlanta, Georgia.
Shock (Augusta, Ga.)
|September 26, 2023

概括
这项研究确定了稳定的基因表达模式,以预测败血症患者的死亡率. 一个机器学习模型准确地预测了结果,帮助重症患者的早期干预.
科学领域:
- 临界护理医学 临界护理医学
- 基因组学就是基因组学.
- 计算生物学 计算生物学
背景情况:
- 败血症是一个全球性的健康挑战,在重症监护病房中死亡率和发病率很高.
- 患者的异质性和动态免疫反应复杂化了败血症结局的风险分层.
- 确定可靠的生物标志物来预测败血症死亡率对于及时干预至关重要.
研究的目的:
- 确定暂时稳定的基因表达标记物,区分败血症幸存者和非幸存者.
- 开发一种动态模型,利用基因表达数据预测败血症患者的死亡率.
- 发现毒症死亡率的潜在生物标志物.
主要方法:
- 来自外围血液的公开可用的时间序列基因表达数据集的二次分析.
- 使用暂时稳定的基因开发支持向量机分类器.
- 使用单独的测试数据集对预测模型进行验证,并进行交叉验证.
主要成果:
- 一个动态模型准确地预测了败血症患者的死亡率,AUC为0.89 (95% CI,0.82-0.96).
- 该模型在测试数据集上表现出强大的性能,采用了交替时间点采样.
- 确定了七种潜在的败血症死亡生物标志物 (STAT5A,CX3CR1,LCP1,SNRPG,RPS27L,LSM5,SHCBP1).这些生物标志物包括:
结论:
- 基于稳定的基因表达的机器学习模型可以准确预测败血症死亡率.
- 已识别的生物标志物需要进一步验证以获得临床应用.
- 该模型具有识别高风险败血症患者和指导治疗策略的潜力.