用监督和无监督机器学习评估Omics数据规范化工具的工作流程
Aleesa E Chua1, Leah D Pfeifer1, Emily R Sekera2
1Department of Chemistry, University of Kansas, Lawrence, Kansas 66045, United States.
Journal of the American Society for Mass Spectrometry
|October 28, 2023

概括
本研究引入了一种灵活的工作流程,以优化质谱 (MS) 数据的规范化. 它使研究人员能够使用机器学习评估任何MS数据类型的任何规范化策略,确保高质量的omics结果.
科学领域:
- 分析化学 分析化学
- 生物技术是生物技术.
- 数据科学数据科学数据科学
背景情况:
- 高质量的omics结果需要解决质谱 (MS) 数据的系统变异性.
- 有效的数据规范化对于最大限度地减少这种变化至关重要.
- 现有的开源软件用于规范化策略选择具有局限性,特别是对于探索新方法的用户.
研究的目的:
- 为在MS数据中识别最佳规范化策略提供简单的工作流.
- 为了能够对任何MS数据类型的任何规范化策略进行评估.
- 将监督和无监督的机器学习纳入绩效评估.
主要方法:
- 开发一个"DIY"工作流程来评估MS数据规范化策略.
- 使用简单的评估指标.
- 监督和无监督机器学习技术的应用.
主要成果:
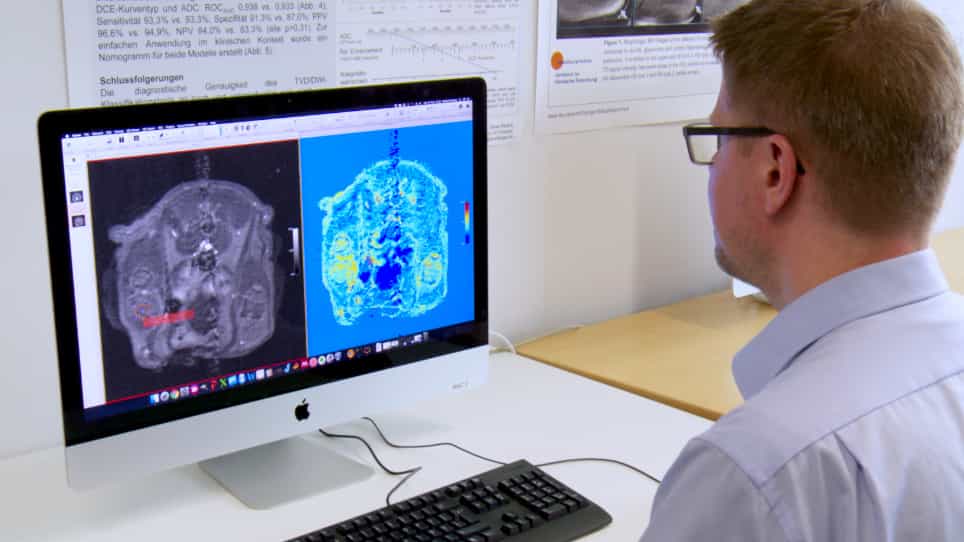
- 在两个不同的数据集上证明了工作流的实用性:隐藏指纹中的脂质的ESI-MS和癌症球状体中的代谢物的MALDI-MSI.
- 成功地确定了每个数据集的表现最好的规范化策略.
- 验证了拟议工作流程的灵活性和有效性.
结论:
- 开发的工作流提供了一个简单而强大的工具,用于优化MS数据规范化.
- 它使研究人员能够测试和验证超越现有的软件限制的新型规范化策略.
- 通过量身定制的规范化方法,促进获得高质量的omics数据.