在多重组织成像中计算单细胞蛋白质丰富度
bioRxiv : the preprint server for biology
|December 18, 2023

概括
机器学习现在可以从多重组织成像中计算单细胞蛋白质的丰富性,克服技术限制. 整合空间数据显著提高了准确性,使得在癌症研究中能够获得更好的生物见解.
科学领域:
- 计算生物学 计算生物学
- 生物医学成像技术 生物医学成像技术
- 机器学习在医学中的应用
背景情况:
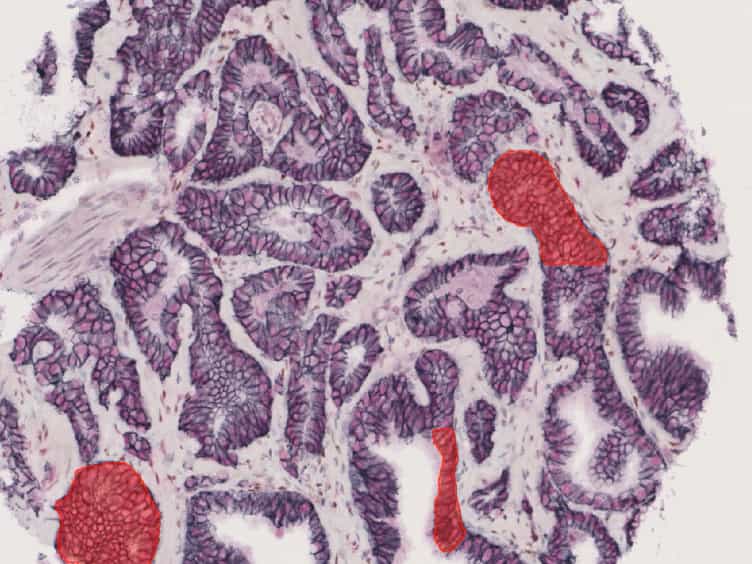
- 多重组织成像为组织特征提供强大的单细胞空间蛋白质组学和转录组学.
- 目前的局限性包括受限制的分子检测,组织损失和蛋白质探针故障,阻碍了实用性.
- 应对这些挑战对于推进空间生物学和精准医学至关重要.
研究的目的:
- 通过使用多重组织成像数据来证明机器学习在归因单细胞蛋白质丰度方面的能力.
- 为了评估和比较不同的机器学习算法对归算精度.
- 评估结合细胞空间信息对归算性能的影响.
主要方法:
- 机器学习技术的比较:规范线性回归,梯度增强回归树和深度学习自动编码器.
- 使用来自乳腺癌队列的多重组织成像数据集对单细胞蛋白质丰度的推算.
- 整合蜂空间信息以提高归算准确度.
主要成果:
- 机器学习成功地归因于单细胞蛋白质表达,平均绝对误差在 [0,1] 尺度上在 0.05-0.3 之间.
- 包括蜂空间信息显著改善了归算性能.
- 假定数据被用来预测活检治疗状态,证明了生物学的相关性.
结论:
- 机器学习为多重成像中的众多蛋白质赋予单细胞丰度水平提供了一种可行的方法.
- 细胞空间数据集成大大提高了蛋白质推算的准确性和实用性.
- 归算的单细胞蛋白质丰度数据具有重要的生物应用潜力,例如治疗反应预测.