转移学习用于17个处于风险的头部和部器官的自动细分:弥合机构和公共数据集之间的差距
Brett Clark1,2, Nicholas Hardcastle2,3,4, Leigh A Johnston1,5,6
1Department of Biomedical Engineering, University of Melbourne, Melbourne, Australia.
Medical physics
|February 20, 2024

概括
使用大型公共数据集进行头部和部风险器官自分类可能是有效的,特别是当机构数据有限时. 转移学习为特定器官提供了适度的改进.
科学领域:
- 医疗成像医学成像
- 辐射瘤学中的人工智能
- 用于医学图像分析的深度学习
背景情况:
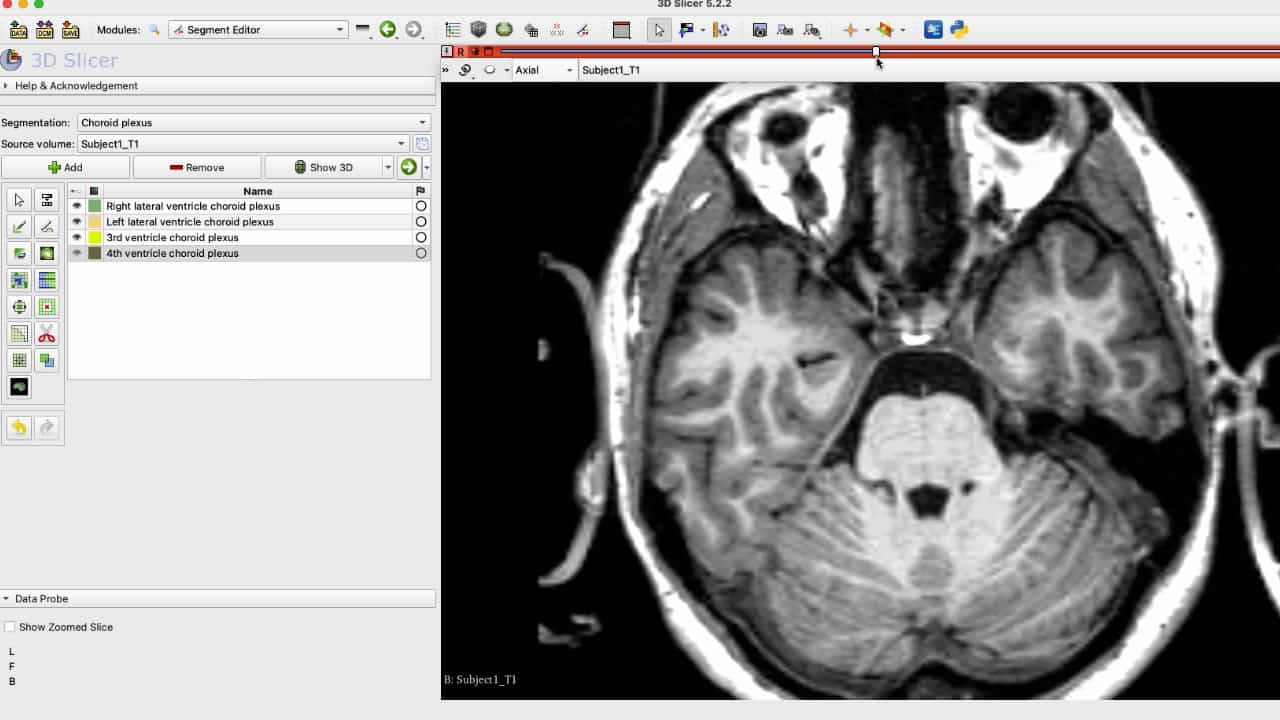
- 头部和部 (HN) CT 扫描中风险器官 (OAR) 的自分区对于放射治疗至关重要,但耗时且容易变化.
- 深度学习 (DL) 模型实现了最先进的结果,但它们的性能取决于数据集.
- 从历史上看,较小的机构数据集 (n < 50) 限制了DL模型的开发;然而,现在可以获得较大的公共数据集 (n > 1000).
研究的目的:
- 评估使用大型公共数据集作为替代或增强机构数据集 (n > 500) 的有效性,用于HN OAR自动细分.
- 评估仅在公共数据与机构数据上训练的DL模型的性能.
- 通过对机构数据进行微调公共模型来研究转移学习的好处.
主要方法:
- 使用大型公共数据集 (公共模型) 和较小的机构数据集 (机构模型) 训练DL自行细分模型.
- 通过转移学习 (转移模型) 对机构数据集进行微调的公共模型.
- 评估了使用五个几何指标 (DSC,表面 DSC,豪斯多夫距离,MSD,添加路径长度) 的模型概括性和性能,并分析了机构数据集大小的影响.
主要成果:
- 公共模型表现优于或与机构模型相比没有显著差异,用于OARs的一个子集 (例如,视神经,脊髓).
- 与机构模型相比,公共模型显示大多数其他OAR的业绩缺口较小.
- 转移模型在几个OAR (例如,脑干,状腺,视神经) 中显示出与机构模型相比显著的性能改善,特别是当机构数据有限时.
结论:
- 对于某些OAR来说,仅仅对公共数据进行培训是可行的,尽管存在小的绩效缺陷,但可能比对机构数据进行广泛的手动策划更好.
- 使用公共预训练模型的转移学习在有机构数据集的情况下为几个OAR提供了适度的绩效增长.
- 利用公共数据集,无论是单独的还是用于预培训,对于HN OAR自动细分是有益的,特别是当机构样本大小受到限制时.