
在美国使用大型语言模型诊断甲状腺结节的协作增强一致性和准确性
Shao-Hong Wu1, Wen-Juan Tong1, Ming-De Li1
1From the Department of Medical Ultrasonics, Ultrasomics Artificial Intelligence X-Laboratory, Institute of Diagnostic and Interventional Ultrasound, First Affiliated Hospital of Sun Yat-sen University, No. 58 Zhongshan Rd 2, Guangzhou 510080, People's Republic of China (S.H.W., W.J.T., M.D. Li, H.T.H., Z.R.H., X.X.L., R.F.L., M.D. Lu, L.D.C., W.W.); and Department of Traditional Chinese Medicine, First Affiliated Hospital of Sun Yat-sen University, Guangzhou, People's Republic of China (X.Z.L.).
Radiology
|March 12, 2024

概括
大型语言模型 (LLM) 在医学成像诊断方面表现有前途. 聊天GPT 4.0表现出卓越的一致性和准确性,特别是在图像到文本集成方面,优于其他模型.
科学领域:
- 医疗成像中的人工智能
- 用于诊断的自然语言处理.
- 机器学习在放射学中的应用
背景情况:
- 大型语言模型 (LLM) 为医学成像解释提供了潜力.
- 有限的研究存在于医学成像诊断推理的LLM可行性.
- 标准化报告和病理学对于评估LLM绩效至关重要.
研究的目的:
- 评估医学成像解释中的三种大型语言模型 (LLM) 的诊断准确性和一致性.
- 研究将LLM与图像到文本和人为循环方法集成的有效性.
- 将不同LLM (ChatGPT 3.5,ChatGPT 4.0,Bard) 的性能与病理学黄金标准进行比较.
主要方法:
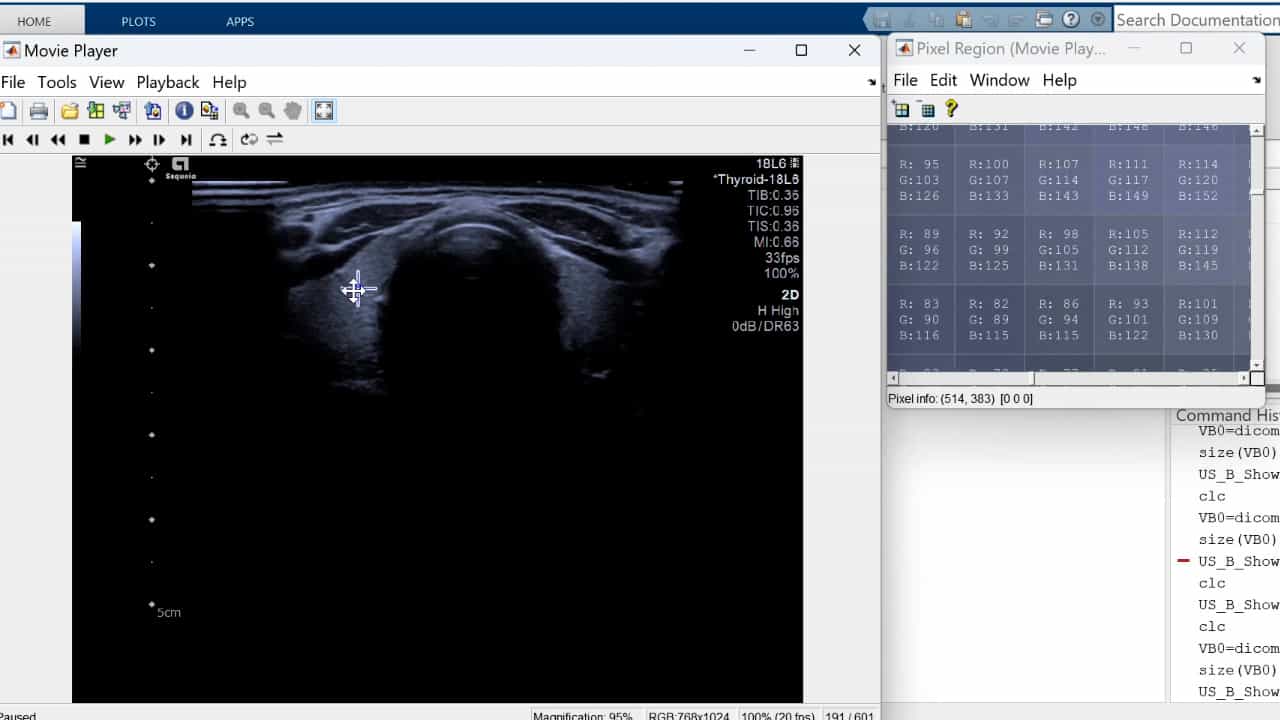
- 对1161张甲状腺结节超声波图像进行了回顾性分析,并得出了病理学结果.
- 对ChatGPT 3.5,ChatGPT 4.0和Bard的诊断性能 (准确度,灵敏度,特异性,AUC) 的评估.
- 与交互式策略的LLM性能比较:人-LLM,图像到文本的LLM,以及卷积神经网络模型.
主要成果:
- 聊天GPT 4.0和巴德显示实质性到几乎完美的LLM内部协议 (κ=0.65-0.86).
- 聊天GPT 4.0实现了78%-86%的准确度和86%-95%的灵敏度.
- 使用ChatGPT 4.0的图像到文本LLM策略显示AUC为0.83和准确率为84%.
结论:
- 在医学成像中,LLM,特别是ChatGPT 4.0,显示出提高诊断准确性和一致性的巨大潜力.
- 将LLM与图像到文本模型集成为改善诊断性能提供了一种可行的策略.
- 士辅助方法在支持放射学临床决策方面表现有前途.