大规模的结构信息多重序列对齐蛋白质与SIMSApiper
Charlotte Crauwels1,2,3, Sophie-Luise Heidig1,3,4, Adrián Díaz1,2,3
1Interuniversity Institute of Bioinformatics in Brussels, ULB-VUB, Brussels, 1050, Belgium.
Bioinformatics (Oxford, England)
|April 22, 2024

概括
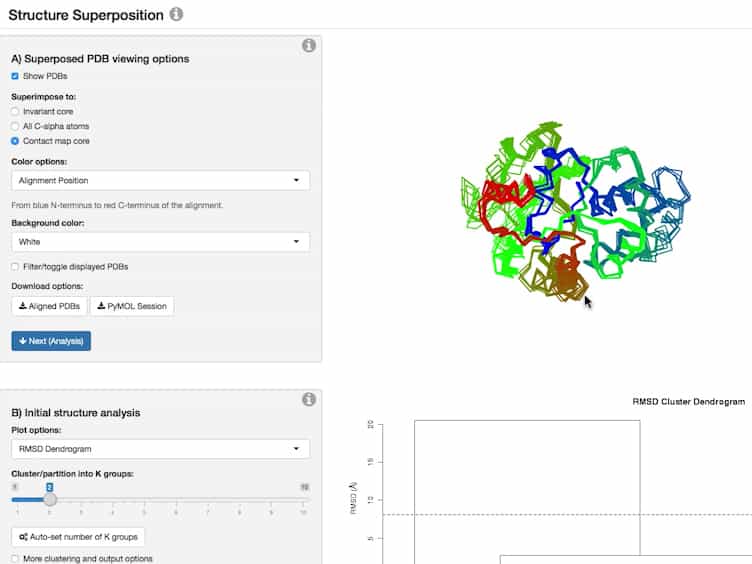
SIMSApiper是一个新的Nextflow管道,用于创建数千个蛋白质序列的可靠,结构知情的多重序列对齐 (MSA). 它通过使用结构信息和并行来显著加快对齐,减少与保存的次要结构之间的差距.
科学领域:
- 生物信息学是一种生物信息学.
- 计算生物学 计算生物学
- 结构生物学 结构生物学
背景情况:
- 多重序列对齐 (MSA) 对于理解蛋白质的功能和进化至关重要.
- 现有的基于结构的对齐方法对于大型数据集来说可能是计算密集和缓慢的.
- 整合结构信息可以提高MSA的准确性和可靠性.
研究的目的:
- 开发一个快速可靠的管道,用于结构信息多重序列对齐.
- 为了使成千上万的蛋白质序列能够高效地对齐.
- 通过利用结构数据来减少MSA的差距.
主要方法:
- 开发了SIMSApiper,这是一个使用Python3和Bash的Nextflow管道.
- 嵌入用户提供的或自动检索的结构信息.
- 基于序列身份子集实施并行化策略.
- 利用保存的二次结构元素来最大限度地减少差距.
主要成果:
- SIMSApiper生成可靠的,结构知情的MSA.
- 管道在速度上明显优于基于结构的标准对齐方法.
- 通过并行技术实现了显著的加快速度.
- 通过有效使用二级结构信息,减少了对齐的差距数量.
结论:
- SIMSApiper为大规模蛋白质序列对齐提供了高效和准确的解决方案.
- 管道集成结构数据的能力提高了MSA质量.
- 它的速度和可靠性使它成为生物信息学研究的宝贵工具.