将人类文本分类性能和可解释性与使用眼球追踪的大型语言和机器学习模型进行比较
Jeevithashree Divya Venkatesh1, Aparajita Jaiswal2, Gaurav Nanda3
1School of Engineering Technology, Purdue University, West Lafayette, IN, 47907, USA.
Scientific reports
|June 21, 2024

概括
这项研究比较了人类,机器学习 (ML) 和大型语言模型 (LLM) 文本分类. ML模型的表现优于LLM和人类,特别是在复杂的伤害叙述方面.
科学领域:
- 人工智能的人工智能
- 人与计算机的交互
- 自然语言处理自然语言处理.
背景情况:
- 将人工智能 (AI) 模型与人类推理进行比较对于AI开发至关重要.
- 文本分类任务,特别是复杂的数据集,对人类和人工智能都构成挑战.
研究的目的:
- 实证地比较文本分类性能和人类的可解释性,传统的机器学习 (ML) 模型和大型语言模型 (LLM).
- 在现实世界分类任务中调查人类和人工智能推理之间的对齐.
主要方法:
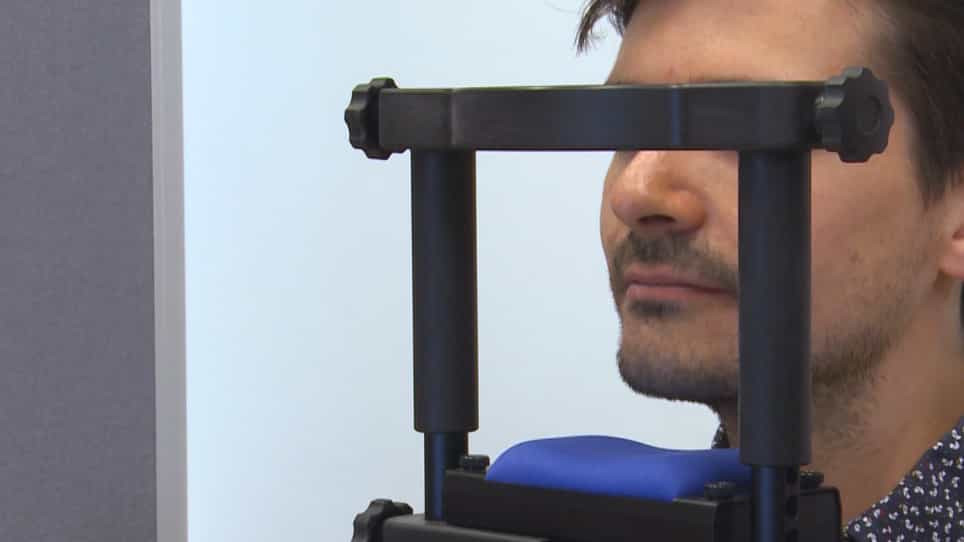
- 一项涉及51名参与者的用户研究将204个受伤叙述分为6个受伤原因代码,并记录了眼睛跟踪数据.
- 使用 120,000 个预先标记的叙述训练 ML 模型; LLM 和人类没有接受任何专业培训.
- 与使用通过眼睛跟踪 (人类),LIME (ML) 和提示 (LLM) 识别的最高分类决策单词相比,可解释性.
主要成果:
- 与零射击的LLM和非专家的人类相比,ML模型表现出优异的分类性能,特别是在复杂和难以分类的叙述中.
- 无论是ML还是LLM,在他们的前3个预测词中,与人类推理的一致性都高于以后的预测词.
- 可解释性分析揭示了决策过程中不同程度的调整.
结论:
- 传统的ML模型仍然可以在特定的,域特定的文本分类任务中超过LLM,特别是有足够的训练数据.
- 虽然LLM表现有前途,但复杂的分类任务中的人类水平的性能和可解释性需要进一步的研究和开发.
- 了解人类和人工智能之间的推理对齐是建立可靠和有效的人工智能系统的关键.
更多相关视频
 08:25
Combining Eye-tracking Data with an Analysis of Video Content from Free-viewing a Video of a Walk in an Urban Park Environment
Published on: May 7, 2019
9.0K
 05:54
Eye-tracking to Distinguish Comprehension-based and Oculomotor-based Regressive Eye Movements During Reading
Published on: October 18, 2018
6.2K