相关实验视频
Updated: Jun 5, 2025
07:42

A Data-Driven Approach to Quantifying Immune States in Sepsis
Published on: February 7, 2025
147
通过使用先进的机器学习框架分析NK细胞相关枢纽基因的全血表达来预测患有败血性休克和败血症的患者
Chao Du1,2,3, Stephanie C Tan2,4, Heng-Fu Bu2,5
1Department of Gastroenterology, Weihai Municipal Hospital of Shandong University, Weihai, Shandong, China.
Frontiers in immunology
|December 13, 2024

概括
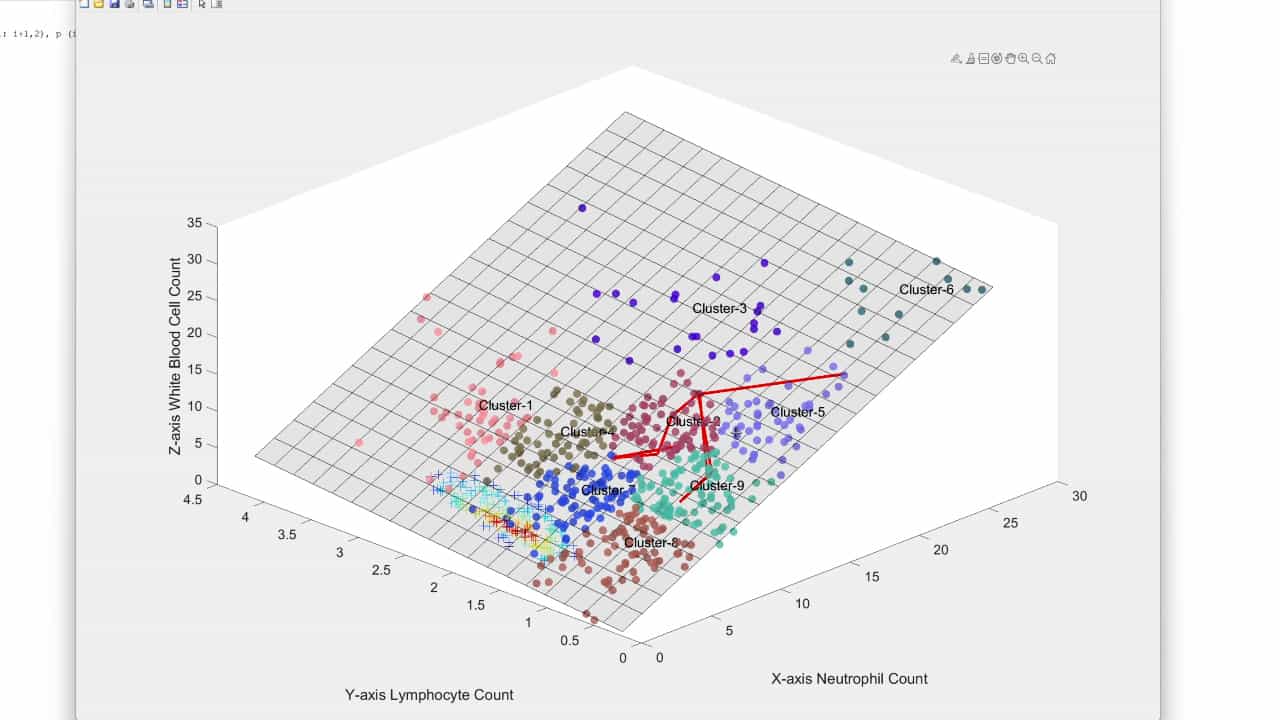
这项研究开发了SepxFindeR,这是一种使用六个枢纽基因 (6-HubGss) 准确预测败血症和败血性休克的机器学习模型. 这种快速诊断工具有助于区分败血症和败血症休克,以便及时照顾患者.
科学领域:
- 基因组学和生物信息学
- 机器学习在医学中的应用
- 关键护理医学 关键护理医学
背景情况:
- 败血症是一种危及生命的疾病,每年导致全球数百万人的死亡.
- 非常需要准确和快速的生物标志物来预测败血症进展到败血症休克.
- 转录组学数据为疾病表型和预测疾病阶段提供了一个有希望的途径.
研究的目的:
- 建立一个先进的机器学习框架,用于预测败血症和败血性休克.
- 为了利用转录学数据集与生物标志物发现的快速周转方法.
- 开发一个预测模型,区分败血症和败血症休克.
主要方法:
- 从外围血液样本中检索和处理了四个NCBI GEO转录组数据集.
- 鉴定了一组六个枢纽基因组 (6-HubGss),与NK细胞细胞毒性和败血性休克有关.
- 开发了一个多阶段机器学习管道 (SepxFindeR) 结合LDA,风险评分分析和LASSO组合方法.
主要成果:
- 确定了六个关键的枢纽基因:GZMB,PRF1,KLRD1,SH2D1A,LCK和CD247.
- SepxFindeR模型在数据库中预测败血症和败血症休克方面表现出很高的准确性.
- 该模型与RT-qPCR数据集相兼容,使得可以快速识别败血症和败血性休克患者.
结论:
- 一个新的生物标志物面板 (6-HubGss) 和机器学习模型 (SepxFindeR) 成功开发.
- SepxFindeR模型能够准确地预测和区分败血症和败血症的败血症休克.
- 开发的方法为临床应用提供了快速处理能力.