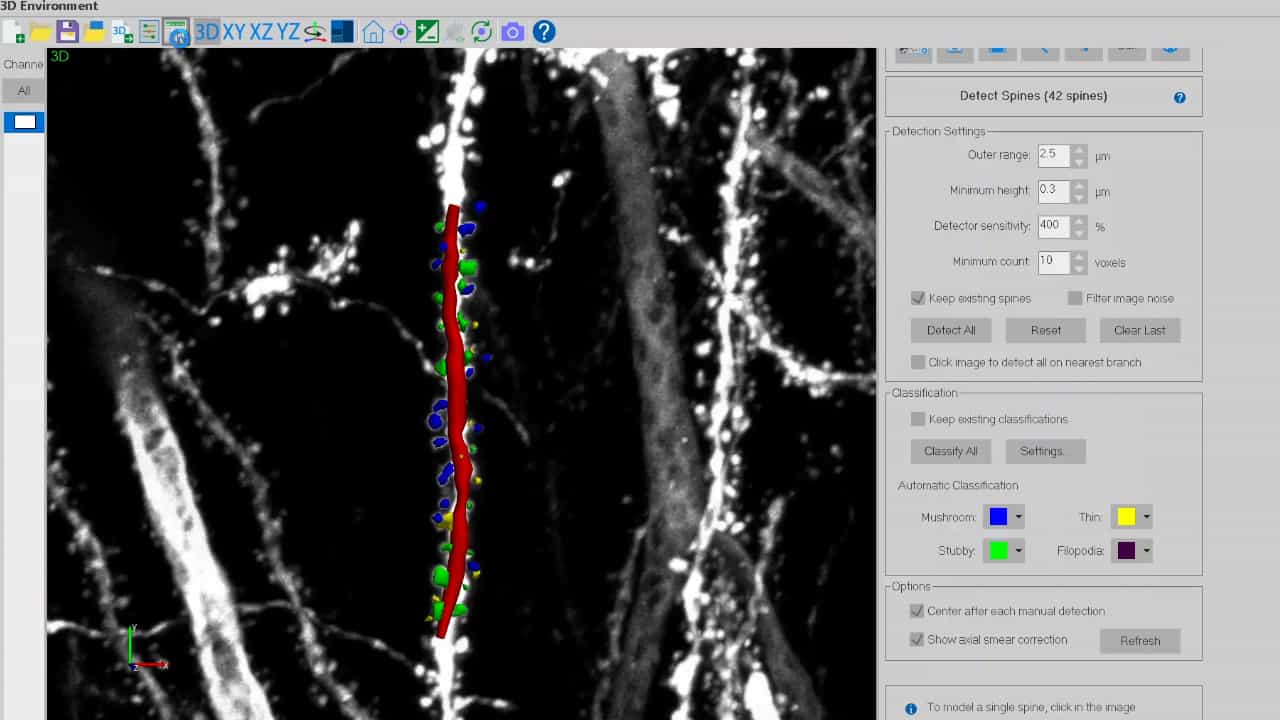
一个三阶段的半监督学习方法来对脊柱图像细分

概括
这项研究引入了一种新型的半监督学习方法,用于细分脊柱CT图像,提高用有限的标记数据检测骨折的准确性. 这种方法提高了工作负载效率和模型性能,即使有资源限制.
科学领域:
- 医疗成像医学成像
- 人工智能的人工智能
- 计算机视觉 计算机视觉
背景情况:
- 在计算机断层扫描 (CT) 图像中精确的脊柱细分对于自动化分析至关重要.
- 现有的数据集往往缺乏标记的断裂数据,阻碍了预测模型的开发.
- 脊椎相似性对精确的细分提出了挑战.
研究的目的:
- 开发一个半监督学习模型,用于脊柱细分,使用标记和未标记的CT数据.
- 为了减少医疗成像分析的手动注释工作量.
- 创建一个能够处理断裂数据的模型,而不需要特定的标记断裂数据集.
主要方法:
- 基于U-Net架构的三阶段2.5D半监督学习方法被采用.
- 一个级联框架,模仿临床检查,被用于精确的脊椎细分.
- 通过2.5D输入补充的2D网络培训被战略性地用于管理大型3DCT数据和GPU约束.
主要成果:
- 初步发现表明,该模型对脊柱区域的细分能力有了显著的改善.
- 该方法显示出有效性,特别是在设备能力有限的环境中.
- 该方法在提高脊柱细分精度和效率方面表现有前途.
结论:
- 拟议的2.5D半监督学习方法为脊柱细分提供了一个可行的解决方案,使用有限的标记数据进行细分.
- 这种方法有效地解决了数据稀缺性和计算局限性带来的挑战.
- 需要进一步的研究,以充分评估其在各种临床场景中的潜力,包括骨折检测.