相关实验视频
Updated: May 21, 2025
07:42
A Data-Driven Approach to Quantifying Immune States in Sepsis
Published on: February 7, 2025
130
在大规模患者数据中用于败血症识别的无监督聚类:一个模型开发和验证研究
Na Li1,2,3, Kiarash Riazi4,5, Jie Pan4,5
1Department of Community Health Sciences, Cumming School of Medicine, University of Calgary, CWPH 5E34, 3280 Hospital Dr. NW, Calgary, AB, T2N 4Z6, Canada. Na.Li@ucalgary.ca.
Intensive care medicine experimental
|March 20, 2025

概括
这项研究引入了一种新的无监督聚类方法,用于识别败血症病例,改善流行病学监测. 该方法有效地使用电子健康记录和行政数据识别败血症表型.
科学领域:
- 医疗信息学医学信息学
- 流行病学 流行病学
- 机器学习是机器学习.
背景情况:
- 败血症是一个重大的全球卫生挑战,复杂的是缺乏确定的病例识别参考标准.
- 现有的败血症识别方法,包括行政代码和基于电子健康记录 (EHR) 的算法,如成人败血症事件 (ASE),具有局限性,并导致发生率变化.
- 临床医生在床边发现败血症仍然具有挑战性,这强调了需要改进识别策略的必要性.
研究的目的:
- 开发和评估一种新的方法来识别使用无监督集群方法的败血症表型.
- 分析已识别的败血症集群的特征,并将其与现有标准 (ASE) 进行比较.
- 评估这种新方法在加强败血症流行病学监测方面的潜力.
主要方法:
- 一项回顾性队列研究利用了来自五个加拿大医疗中心 (2015-2017) 成人重症监护室 (ICU) 住院的医院行政和EHR数据.
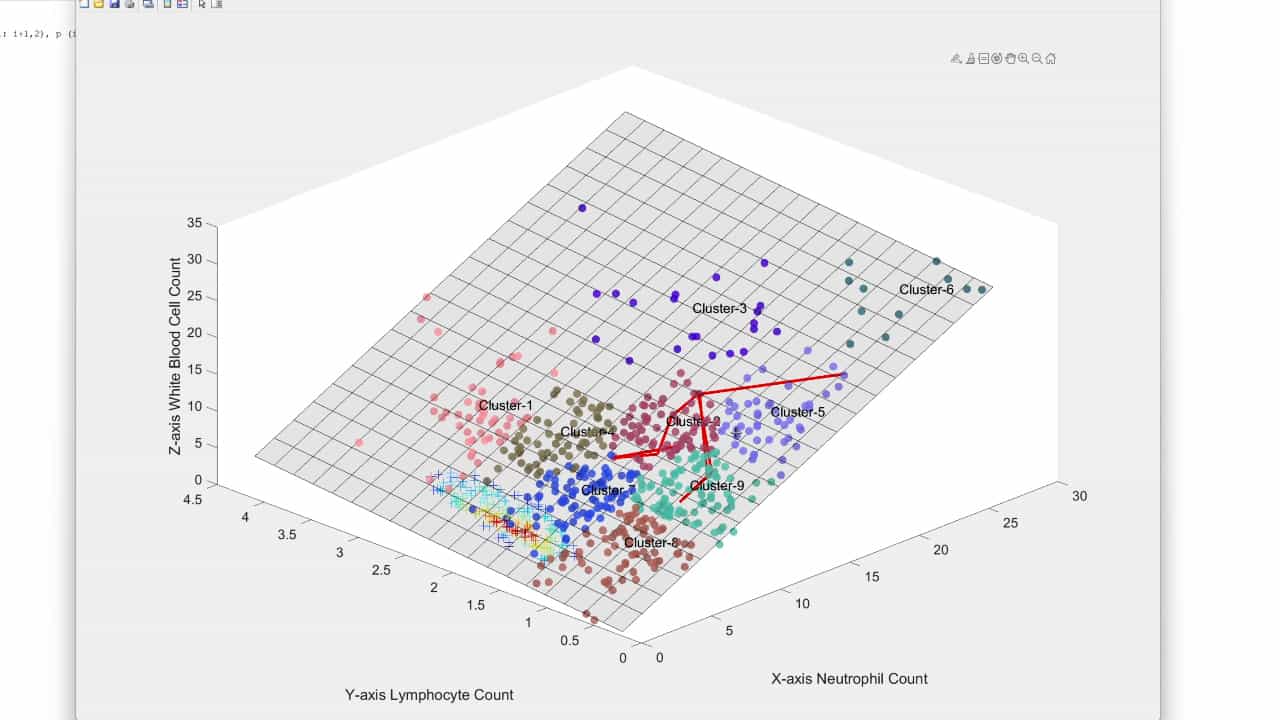
- 对592个变量应用了数据缩小技术,随后对55个主要组件应用了8个集群算法.
- 根据最佳集群指标选择了强大而稀缺的K-means集群 (RSKC) 方法,并使用XGBoost模型验证了集群成员资格.
主要成果:
- 该RSKC方法在发展队列 (3660名患者) 中确定了48个不同的住院集群.
- 11个"ASE多数"集群,包括22.4%的患者,包含77.8%的符合 ASE败血症标准的所有患者.
- 在这些多数群体中,不符合ASE标准的患者中有很大一部分 (34.9%) 符合更自由的败血症标准,这表明目前的方法可能不足.
结论:
- 大规模,多样化的医疗数据的无监督聚类为识别败血症表型提供了一个有希望的途径.
- 这种方法为精确和一致的败血症流行病学监测提供了潜在的改善.
- 已识别的集群为败血症表现提供了细微的视图,有助于更好地了解这种情况.