单一可通用AI败血症预测模型的虚假希望:基于追溯的多站点队列研究,偏见和提议的缓解策略来提高性能
Rudolf Schnetler1,2, Anton van der Vegt3, Vikrant R Kalke4
1Townsville Institute of Health Research and Innovation, Townsville Hospital and Health Service, Townsville, Queensland, Australia.
BMJ quality & safety
|March 26, 2025

概括
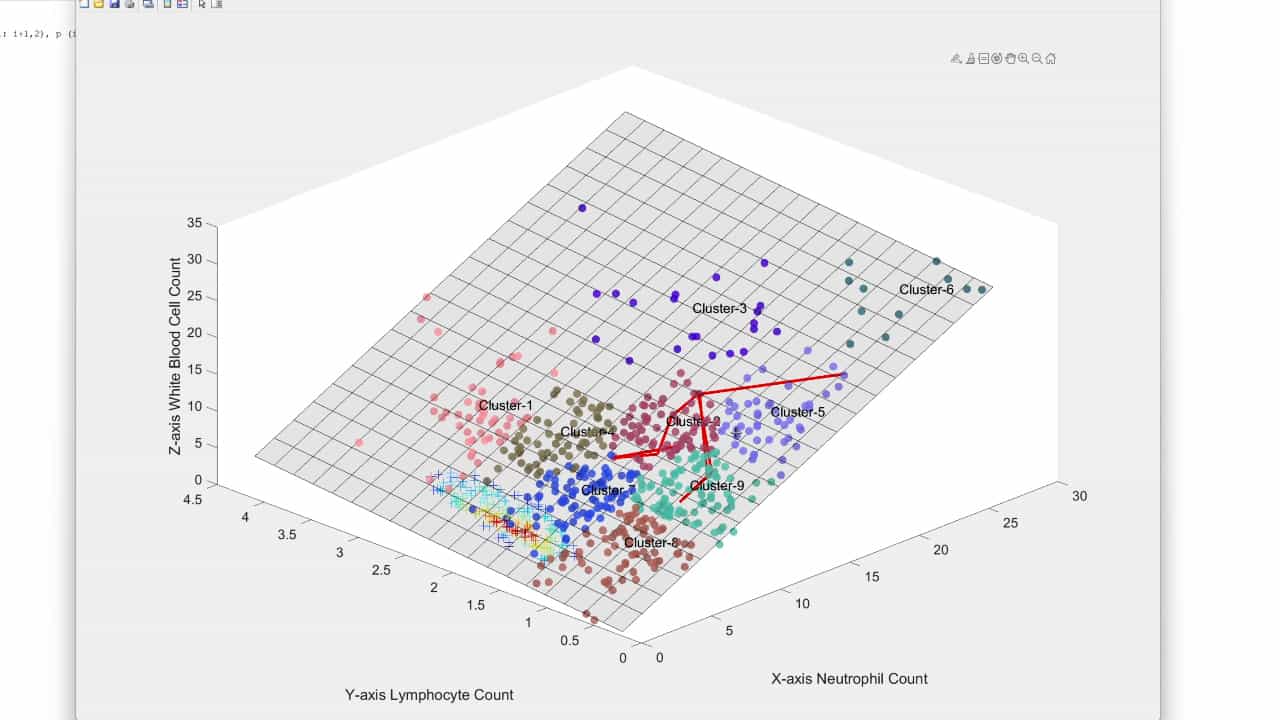
一个单一的机器学习 (ML) 败血症预测模型显示了医院和护理机构的重大偏差. 针对应急部门 (ED) 和病房单独训练的定制模型减少了警报负担,而不影响预测时间.
科学领域:
- 医疗信息学 医疗信息学
- 临床决策支持 临床决策支持
- 医疗保健中的机器学习
背景情况:
- 败血症预测模型对于及时干预至关重要.
- 一个单一的机器学习 (ML) 模型可能会在不同的医院设置和护理地点中表现出差异.
- 识别和减轻ML模型中的偏差对于公平有效的医疗保健服务至关重要.
研究的目的:
- 在多个医院和护理环境中识别单个ML败血症预测模型中的偏差.
- 评估六种偏差缓解策略对模型性能的影响.
- 为开发高性能败血症预测模型提出一种通用建模方法.
主要方法:
- 开发了一个基线ML模型,使用九家医院的969,292名患者入院的回顾性数据.
- 评估模型的性能是使用评估所需的数量 (NNE) 和预测败血症的时间 (HTS3) 来评估的.
- 与基线模型对其对NNE和HTS3.3的影响进行了比较,对六种偏差缓解策略进行了比较.
主要成果:
- 基线ML模型表明,急救部门和病房之间的NNE有显著差异.
- 偏差缓解模型改善了NNE,但没有显著改变HTS3.
- 在ED或病房数据上单独训练的模型在九家医院中的七家医院中获得了最低的NNE,并减少了医院间的差异.
结论:
- 由于性能差异,单一的,通用的ML败血症预测模型可能不适合多医院系统.
- 偏差缓解技术可以提高模型性能,减少跨站点的警报负担.
- 目前的偏差缓解策略不会延长毒症检测的预测窗口.