相关实验视频
Updated: May 15, 2025
08:06

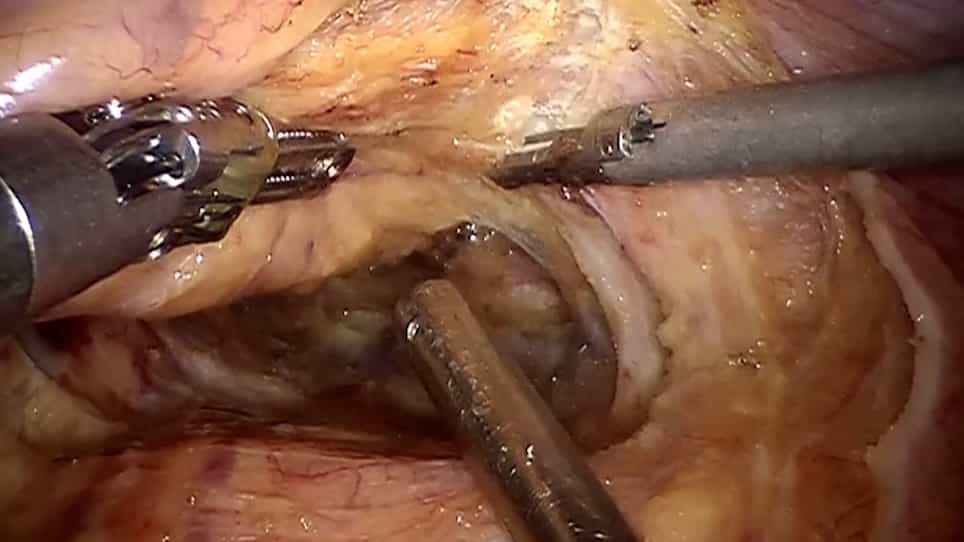
Mixed Reality Assisted Radical Endoscopic Thyroidectomy
Published on: January 31, 2025
174
人工智能增强:GPT-4和GPT-3.5在整形外科现役检查中的表现
Daniel Najafali1, Erik Reiche2, Sthefano Araya3
1From the Carle Illinois College of Medicine, University of Illinois Urbana-Champaign, Urbana, IL.
Plastic and reconstructive surgery. Global open
|April 11, 2025

概括
与GPT-3.5相比,GPT-4在整形外科现役检查中表现得更好,但仍然落后于经验丰富的住院医生. 人工智能需要进一步发展,才能成为可靠的外科教育工具.
科学领域:
- 医疗教育中的人工智能
- 在外科手术中使用大型语言模型.
- 整形外科培训 整形外科培训
背景情况:
- 聊天GPT-3.5在整形外科现役检查中获得了52百分点,相当于一年级住院医生.
- 先进的GPT-4模型及其更大的训练数据集被评估为潜在的增强性能.
- 这项研究假设GPT-4将超过GPT-3.5,在外科教育中提供更大的实用性.
研究的目的:
- 评估GPT-4和GPT-3.5在2022年整形外科现役检查中的表现.
- 将AI性能与整形外科住院医生的国家指标进行比较.
- 确定GPT-4作为外科教育工具的潜力.
主要方法:
- GPT-4和GPT-3.5是2022年整形外科现役考试中的问题.
- 在两种AI模型中都采用了三种不同的提示策略.
- 性能与2022年美国塑料外科医生协会规范表进行了基准测试.
主要成果:
- GPT-4的整体准确率达到63%,超过了GPT-3.5的58%准确率.
- 对于GPT-4的最高准确率是68%,使用多选择题和解释,在第一年居民中达到第93个百分位.
- 尽管有所改善,GPT-4的最佳表现 (68%) 将其置于第六年居民的第15百分位.
结论:
- 在整形外科现役检查中,GPT-4的表现明显优于GPT-3.5.
- 当前的人工智能性能虽然有所提高,但尚未与经验丰富的住院医生或主治外科医生相匹配.
- 需要进一步改进人工智能模型,以确定其作为综合性外科教育资源的价值.