相关实验视频
Updated: May 7, 2026


An R-Based Landscape Validation of a Competing Risk Model
Published on: September 16, 2022
对大型语言模型在回答临床问题的信心进行基准测试:跨截面评估研究
Mahmud Omar1, Reem Agbareia2, Benjamin S Glicksberg1
1Division of Data-Driven and Digital Medicine (D3M), Department of Medicine, Icahn School of Medicine at Mount Sinai, Gustave L. Levy Place New York, New York, NY, 10029, United States, 1 212 241 6500.

大型语言模型 (LLM) 显示对生物医学准确性的反向信心,较差的模型更有信心. 即使是顶级模型在正确和不正确的答案之间也有最小的信心差异,限制了临床使用.
科学领域:
- 人工智能在医学中的应用
- 生物医学信息学 生物医学信息学
- 临床决策支持 临床决策支持
背景情况:
- 大型语言模型 (LLM) 在回答生物医学问题的信心方面的自我评估能力尚未得到充分理解.
- 评估LLM信心对于他们安全地融入医疗保健至关重要.
研究的目的:
- 评估五个医学专业的12个LLM的信心水平.
- 确定LLM是否能够在临床知识背景下准确地判断他们自己的反应.
主要方法:
- 利用了1965年的多选题,涵盖内科,产科/妇科,精神病学,儿科和手术.
- 模型为每个问题提供了答案和信心分数 (0%-100%).
- 对正确答案的相关平均信心分数与整体模型准确度;使用t测试分析正确和不正确答案之间的信心差异.
主要成果:
- 在正确答案的平均信心和模型准确性之间发现了反向相关性 (r=-0.40,P=.001).
- 性能较差的模型表现出更高的信心;例如,Qwen2-7B (46%准确率) 有76%的信心,而GPT-4o (74%准确率) 有63%的信心.
- 在所有模型中,正确和不正确答案之间的平均信心差异很小 (0.6%-5.4%),表明歧视不佳.
结论:
- 虽然表现更好的LLM表现出更一致的信心,但即使是最准确的模型在正确和不正确的答案之间也表现出最小的信心变化.
- 这种有限的信心校准可能会限制LLMs的安全临床应用.
- 需要改进校准,特定领域的微调和人类监督等策略来提高医疗保健中的LLM可靠性.
更多相关视频
 03:14
Augmenting Large Language Models via Vector Embeddings to Improve Domain-Specific Responsiveness
Published on: December 6, 2024
 05:47
Evidence-based Knowledge Synthesis and Hypothesis Validation: Navigating Biomedical Knowledge Bases via Explainable AI and Agentic Systems
Published on: June 13, 2025
相关概念视频
 01:19
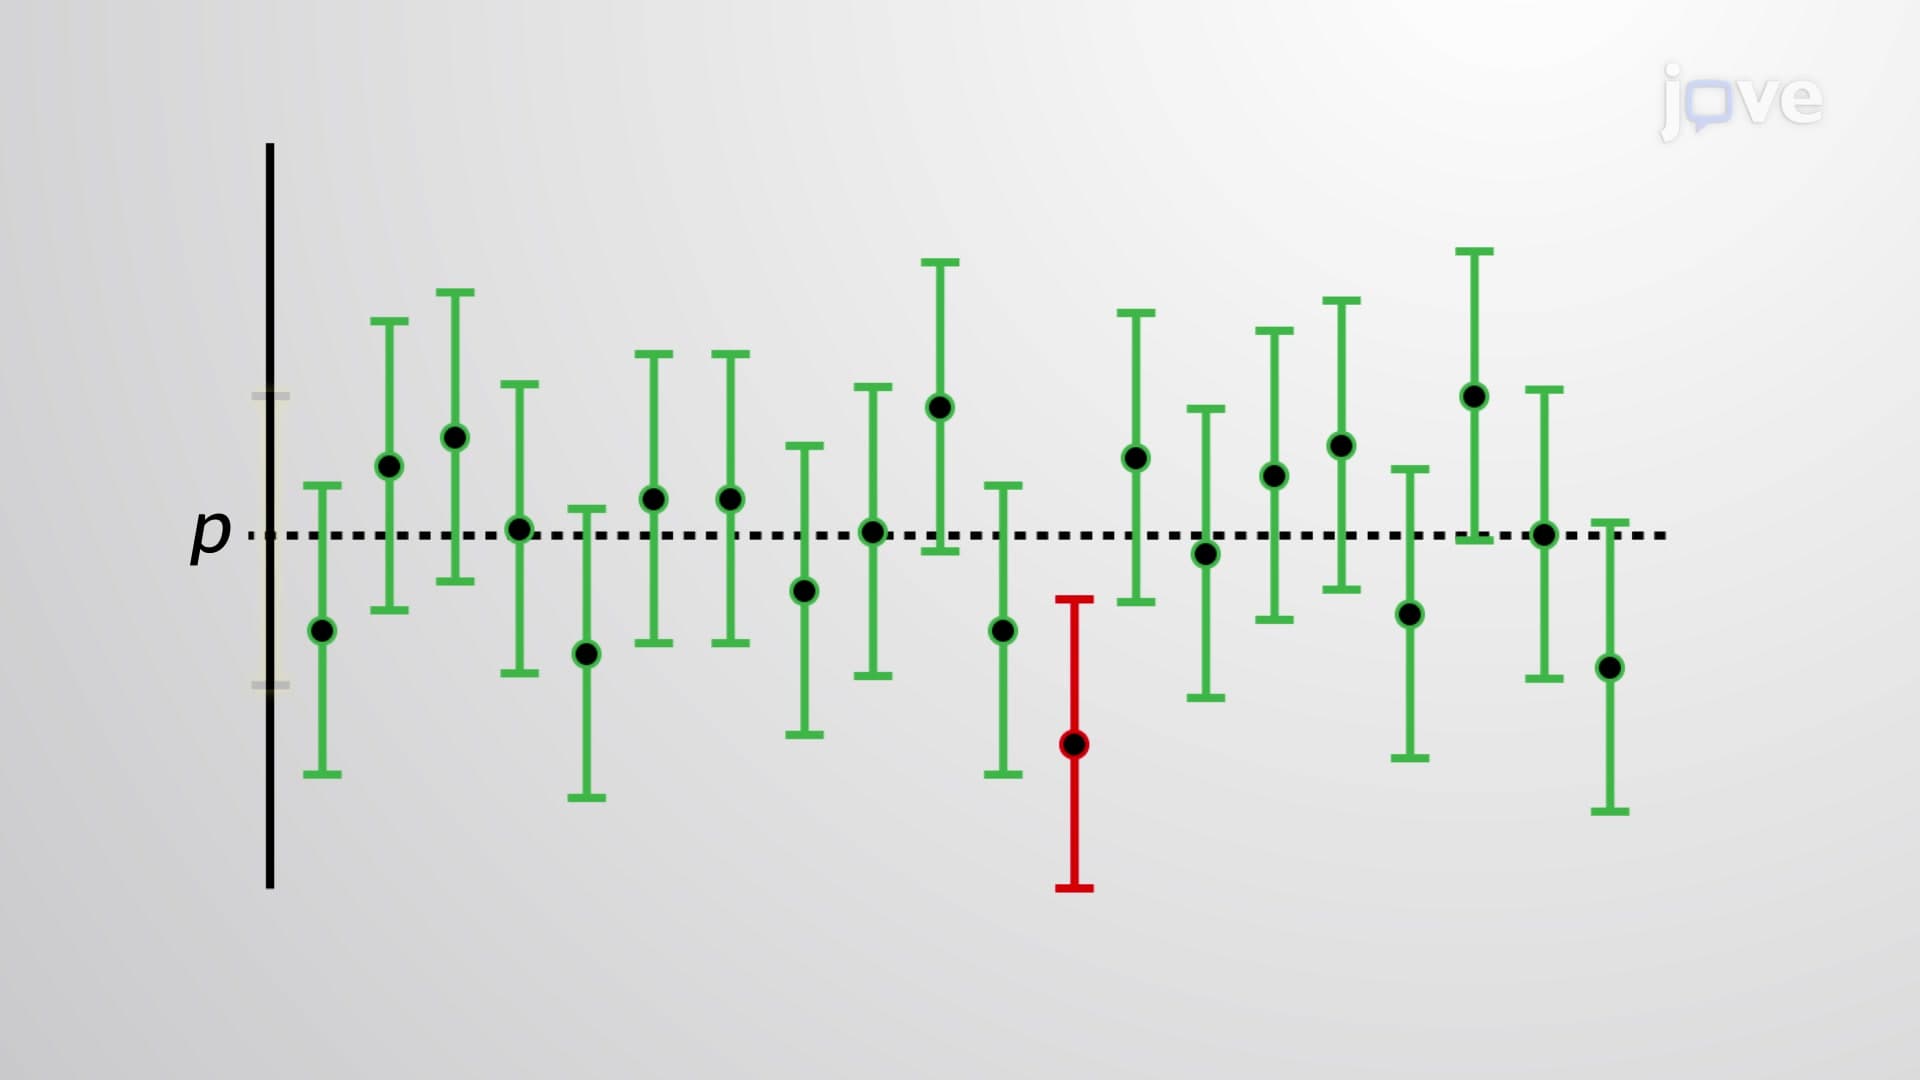
Interpretation of Confidence Intervals
Confidence intervals have confidence coefficients that are crucial for their interpretation. The most common confidence coefficients are 0.90, 0.95, and 0.99, which can be written as percentages–90%, 95%, and 99%, respectively.
Suppose a person calculates a confidence interval with a confidence coefficient of 0.95. In that case, they can...
 01:16
Clinical Trials
There are four phases in a clinical trial. A phase one...