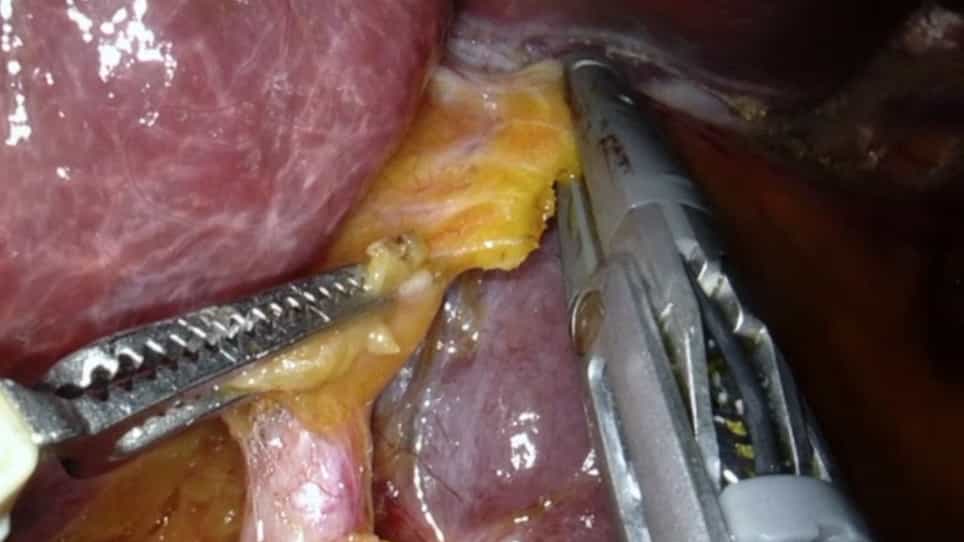

在患者教育中评估人工智能:DeepSeek-V3与ChatGPT-4o在回答 laparoscopic胆囊切除术常见问题的过程中
Hilmi Anil Dincer1, Dogukan Dogu2
1Faculty of Medicine, Department of General Surgery, Hacettepe University, Ankara, Turkey.
ANZ journal of surgery
|June 11, 2025

概括
DeepSeek-V3,一个新的AI大语言模型,为患者关于腹腔镜胆囊切除术 (LC) 的问题提供了比ChatGPT-4o更合适的答案. 这项研究突出了DeepSeek-V3的重点.
科学领域:
- 医疗信息学 医疗信息学
- 医疗保健中的人工智能
- 外科教育的外科教育
背景情况:
- 人工智能大语言模型 (LLM) 越来越多地用于医疗信息检索.
- 人工智能产生的医学见解的准确性和可靠性存在担忧.
- DeepSeek-V3是一个基于人工智能的新型LLM,在东亚开发.
研究的目的:
- 评估来自ChatGPT-4o和DeepSeek-V3.3的响应的适当性,准确性和可读性.
- 评估人工智能生成的答案在腹腔镜胆囊切除术 (LC) 患者教育中的可用性.
主要方法:
- 关于LC的20个常见患者问题被提出给DeepSeek-V3和ChatGPT-4o.
- 答案由两名经过董事会认证的全科医生使用利克尔特比例表来评估全面性和适当性.
- 统计分析包括配对样本t测试,威尔科克森签名排名测试和科恩的卡帕对评级者之间的可靠性.
主要成果:
- 在统计学上,DeepSeek-V3提供了比ChatGPT-4o (p=0.033) 更合适的响应.
- 在95%的问题中,DeepSeek-V3获得了5分的评分,而ChatGPT-4o的评分为65%.
- 外科医生发现DeepSeek-V3的反应在统计学上显著更合适 (p=0.008).
结论:
- 2025年1月发布的DeepSeek-V3在回答患者关于LC的询问方面表现出卓越的性能.
- 人工智能模型为患者教育提供了更合适的响应,而不是像ChatGPT-4o这样的现有模型.