相关实验视频
Updated: Jan 15, 2026
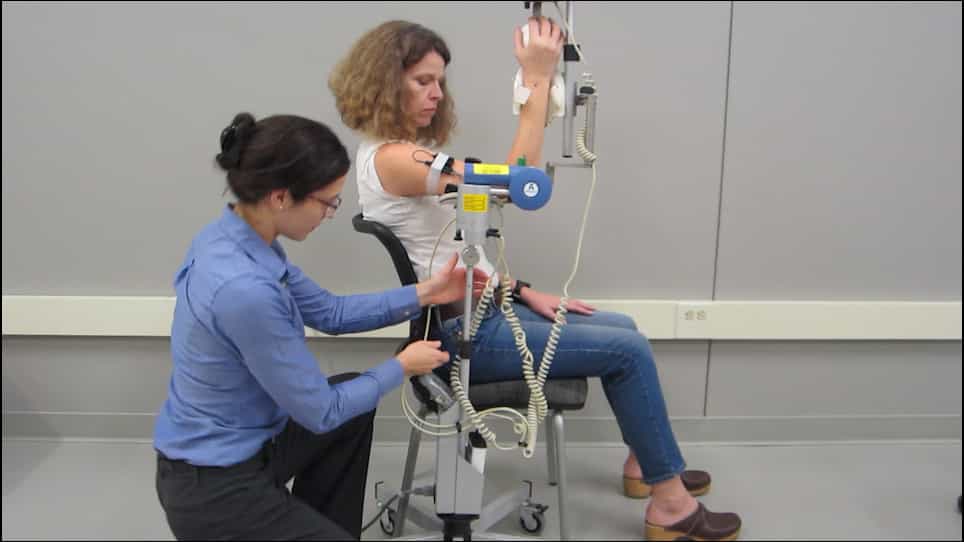
07:56

A Standardized Method for Measurement of Elbow Kinesthesia
Published on: October 10, 2020
7.9K
补充而不是替代:对常见肘部病理的ChatGPT反应的准确性和完整性
Benjamin Fiedler1, Umar Ghilzai1, Abdullah Ghali1
1Joseph Barnhart Department of Orthopedic Surgery, Baylor College of Medicine, Houston, TX, USA.
Shoulder & elbow
|October 9, 2025

概括
像ChatGPT这样的大型语言模型 (LLM) 可以准确地回答患者关于肘部疾病的问题. 与ChatGPT 3.5相比,GPT-4提供了更完整和更准确的响应,这表明LLM是可靠的在线健康资源.
科学领域:
- 整形外科手术 整形外科手术
- 人工智能在医学中的应用
- 医疗信息学 医疗信息学
背景情况:
- 寻求健康信息的患者越来越多地使用大型语言模型 (LLM).
- 对骨科疾病的LLM反应的准确性和完整性进行评估至关重要.
- 对于患者特定的骨科查询,关于LLM绩效的数据有限.
研究的目的:
- 为了比较评估ChatGPT 3.5和GPT-4响应的准确性和完整性.
- 评估有关常见肘部病理的常见问题上的LLM绩效.
- 为了确定与ChatGPT 3.5.5相比,GPT-4是否提供了更好的响应.
主要方法:
- 聊天GPT 3.5和GPT-4被询问了常见的肘部病理和相关的患者问题.
- 对两种LLM版本提出了涵盖五个肘部疾病的25个问题.
- 整形外科医生对答案的准确性 (6点利克特) 和完整性 (3点利克特) 进行了评分.
主要成果:
- 聊天GPT 3.5和GPT-4都表现出高精度,GPT-4的平均得分略高 (5.0对4.83,p=0.05).
- 与ChatGPT 3.5 (2.66与2.35相比,p=0.01) 相比,GPT-4的完整性得分也显著提高.
- 平均准确度分数为ChatGPT 3.5的4.80-4.87和GPT-4.4的4.80-5.13之间.
结论:
- 聊天GPT 3.5和GPT-4提供准确和完整的答案,患者对肘部疾病的问题.
- 与ChatGPT 3.5.5相比,GPT-4在准确性和完整性方面表现出优越的性能.
- 像ChatGPT这样的LLM显示出对管理肘部疾病的患者作为可靠的在线资源的潜力.