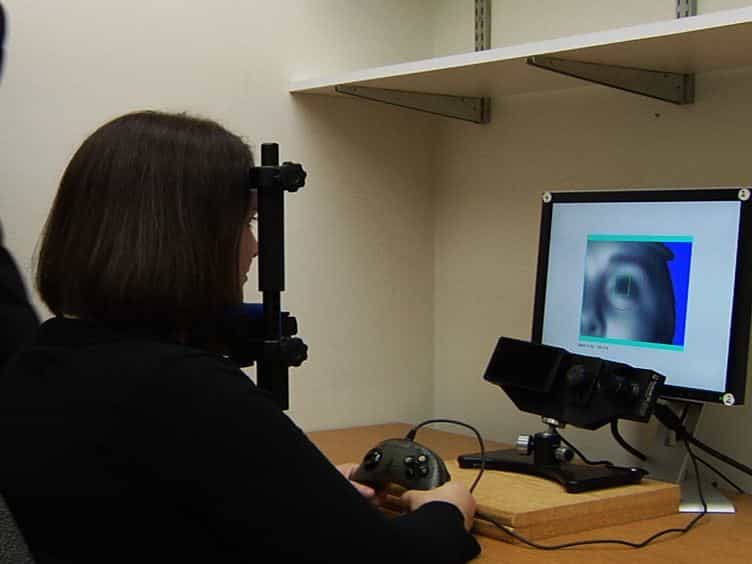
用大型语言模型和眼睛跟踪生物标志物进行阅读理解分析的图形表示

概括
大型语言模型 (LLM) 通过将文本表示为图表来显示一致的语言理解. 这项研究将LLM图形结构与人眼跟踪数据进行比较,以获得更好的阅读理解洞察力.
科学领域:
- 认知科学 认知科学
- 人工智能的人工智能
- 自然语言处理自然语言处理.
背景情况:
- 阅读理解对于认知发展至关重要.
- 比较人类和大型语言模型 (LLM) 的语言理解越来越重要.
- 之前的研究分析了单词级理解,但缺乏深度.
研究的目的:
- 用基于图形的文本表示来比较人类和LLM阅读理解.
- 调查LLM在理解文本内语义关系中的一致性.
- 为人类-人工智能共同学习策略提供信息.
主要方法:
- 利用基于LLM的AI代理来从文本中创建图形结构,将单词表示为节点,语义关系表示为边缘.
- 员工以问题为导向提示以指导图形构建.
- 对比了人类眼睛对图形元素 (节点和边缘) 的固定分布.
主要成果:
- 在图形拓结构层面上,LLM在语言理解方面表现出很高的一致性.
- 对图形结构的眼睛固定模式为语义相关性提供了洞察力.
- 基于图形的方法提供了比单词级别分析更深入的理解.
结论:
- 当文本以图形形式表示时,LLM表现出强大而一致的语义理解.
- 基于图形的文本表示增强了阅读理解的分析.
- 这些发现支持在学习中开发有效的人类-人工智能协作.
更多相关视频
 07:36
Eye Tracking During Visually Situated Language Comprehension: Flexibility and Limitations in Uncovering Visual Context Effects
Published on: November 30, 2018
16.3K
 05:54
Eye-tracking to Distinguish Comprehension-based and Oculomotor-based Regressive Eye Movements During Reading
Published on: October 18, 2018
6.6K