多输出学习用于DNA甲基化数组中的系统缺失值赋值
Tao Ma1, Jinfu Nie2, Jian Huang3
1Division of Computational Biology, Department of Quantitative Health Sciences, Mayo Clinic College of Medicine & Science, Rochester, MN 55905, United States.
Bioinformatics advances
|March 5, 2026

概括
这项研究引入了一种新的归算框架,以解决因Illumina阵列更新引起的缺失DNA甲基化数据. 该方法有效地整合了各种数据集,并改进了表观遗传年龄预测模型.
科学领域:
- 基因组学就是基因组学.
- 表观遗传学 在表观遗传学中,表观遗传学是指表观遗传学.
- 生物信息学是一种生物信息学.
背景情况:
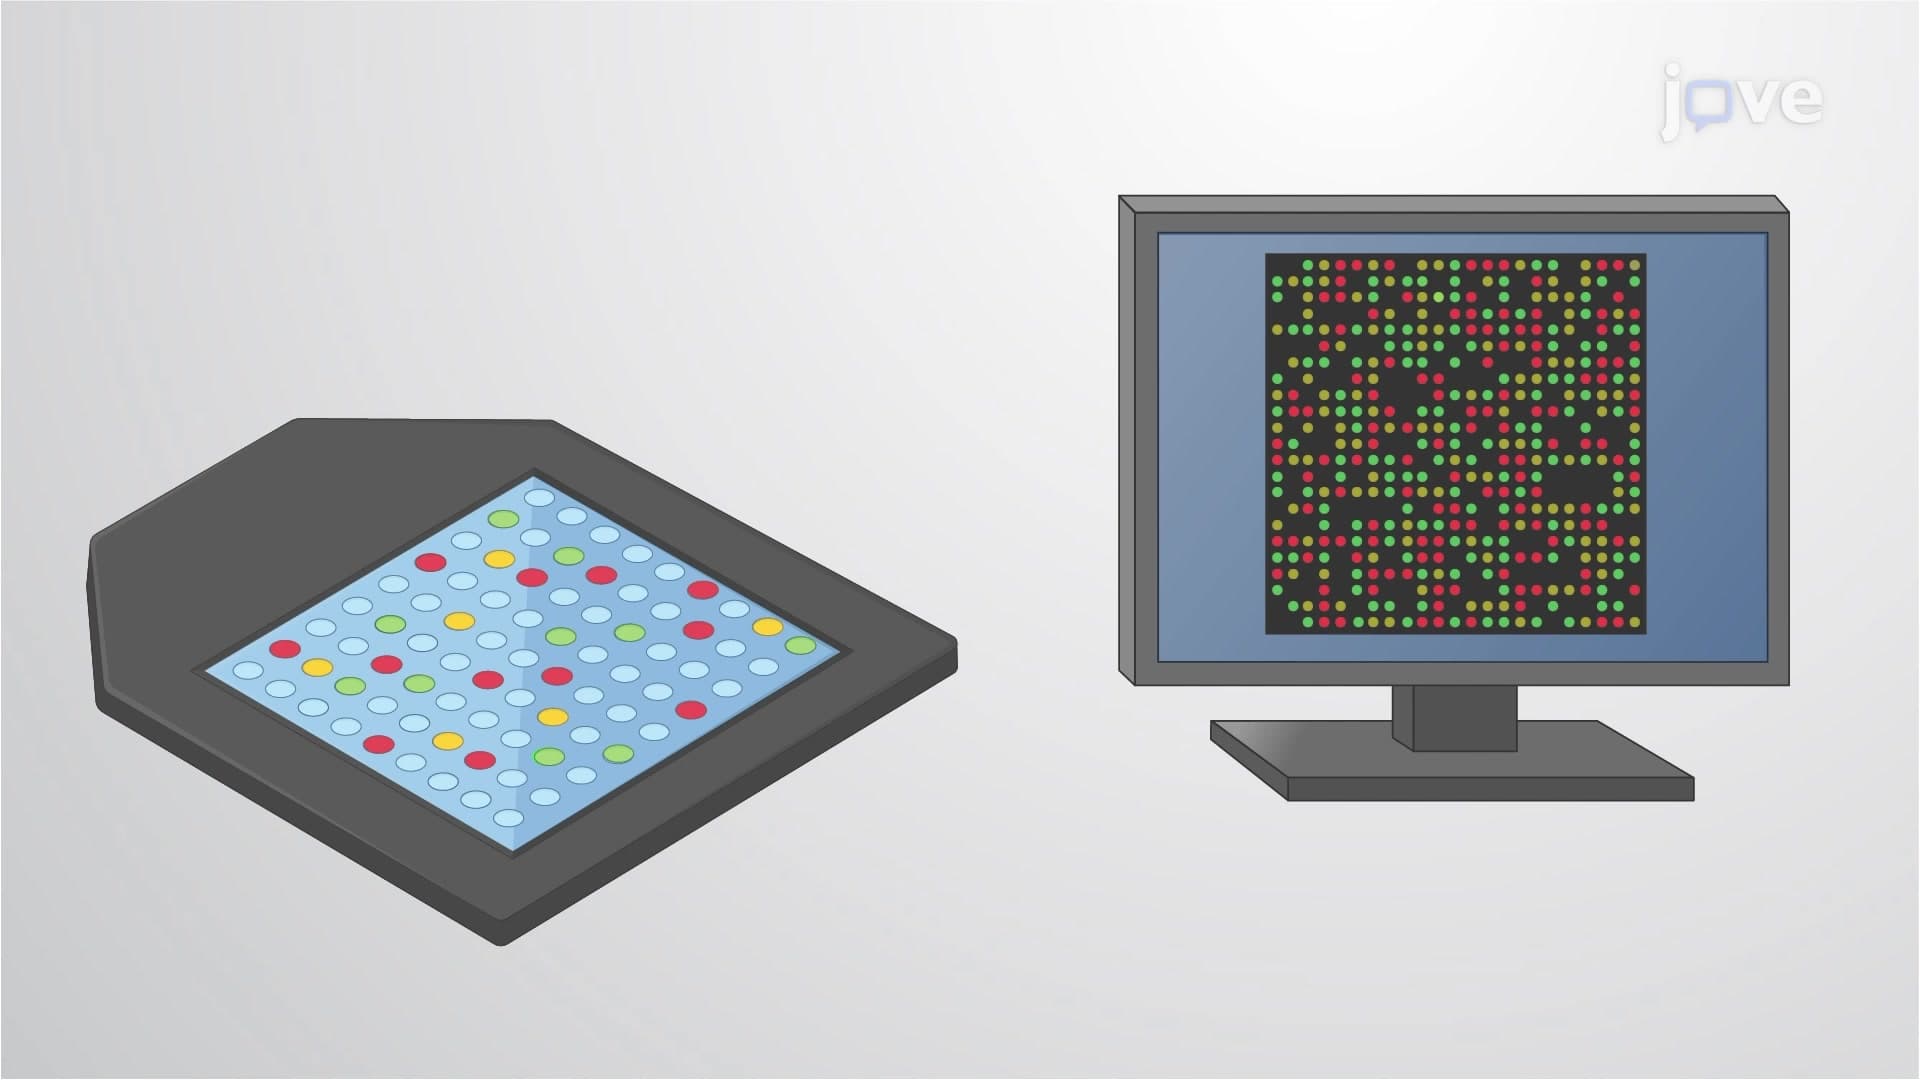
- 伊卢米纳DNA甲基化阵列经历了快速的进化,导致基因组覆盖范围的扩大,但也导致了向后不兼容性.
- 在数组版本中删除CpG站点会产生系统性的缺失值,阻碍了遗留数据集的集成和重用.
研究的目的:
- 开发和验证一个强大的归算框架,以解决系统性缺失的DNA甲基化值.
- 为了实现跨不同Illumina阵列代和其他表观基因组数据类型的无数据集成.
- 为了提高下游表观遗传分析的性能,例如表观遗传年龄预测.
主要方法:
- 开发了一个两阶段的归算框架,最初使用标准技术解决随机失踪问题.
- 第二阶段使用多输出机器学习模型 (SVR,k-NN,随机森林,DNN) 来归因系统的缺失值.
- 该框架在真实数据集上进行了评估,并与传统的归算方法进行了比较.
主要成果:
- 拟议的框架在数据集中始终优于传统的归算方法,缺失率高达50%.
- 在甲基化阵列和减少表示 bisulfite 测序数据之间实现了缺失 CpG 位点的准确归算,促进了跨平台集成.
- 对脑瘤甲基化数据集的分析显示,阵列特定模式的恢复和生物复杂性的保存.
- 缺少甲基化位点的归算显著改善了表观遗传年龄预测模型的性能.
结论:
- 开发的归算框架有效地处理系统性缺失的DNA甲基化数据,从而实现强大的跨平台和跨数组集成.
- 这种方法保留了生物复杂性,并提高了表观遗传年龄预测的准确性.
- "超引算"Python包为研究人员提供了一个免费可用的工具来实施这种引算策略.
更多相关视频
 13:47
Enhanced Reduced Representation Bisulfite Sequencing for Assessment of DNA Methylation at Base Pair Resolution
Published on: February 24, 2015
26.5K
 13:21
Comprehensive DNA Methylation Analysis Using a Methyl-CpG-binding Domain Capture-based Method in Chronic Lymphocytic Leukemia Patients
Published on: June 16, 2017
10.6K